はじめに
木構造やグラフ構造の探索アルゴリズムとして、DFS(深さ優先探索)とBFS(幅優先探索)というものがあります。
アルゴリズム系はめっぽう弱く(というか学んでいない)、BFSもDFSもちらっと聞いたことはあるけど全くわからんという筆者でした。
しかし、コードベース & 図解で処理をイメージ & そのアルゴリズムが必要なユースケースを通して理解し、その活用法を知ることで、かなり解像度は高くなりました。(友人から教えてもらったのも大きかった)
せっかくなので記事としてまとめておこうと思います。
なお、本記事で扱っているデータ構造は木構造に絞っています。
概念と処理をコードベース & 図解で考える
木構造を探索する際のアルゴリズムの二つに関して、それぞれ述べていきます。概念的な話には図解を用いながら、そしてコードベースで処理を具体的に追ってみましょう。
以下のような木構造で考えてみます。
上に示した図解の構造をコードで表現すると以下のような感じになりました。
コードで表現した木構造
// ノードは複数の子ノードを持つ
type Node struct {
	value    string
	children []Node
}

// N分木
var tree = Node{
	value: "A",
	children: []Node{
        {
            value: "B",
            children: []Node{
                {value: "D"},
                {value: "E", children: []Node{{value: "I"}, {value: "J"}}},
            },
        },
        {
            value: "C",
            children: []Node{
                {value: "F"},
                {value: "G", children: []Node{{value: "K"}}},
                {value: "H"},
            },
        },
    },
}
深さ優先探索(DFS)
DFS・・・すなわち、Depth-First Searchのことです。ざっくり言えば、
行けるところまで一気に深く潜って調べて、行き止まりになったら戻るを繰り返す
探索法です。
可能な限り深く潜って、それ以上潜れなくなったら戻る、を繰り返します。そのため、示したような順番でそれぞれのノード(1つ1つの要素)を辿ることになります。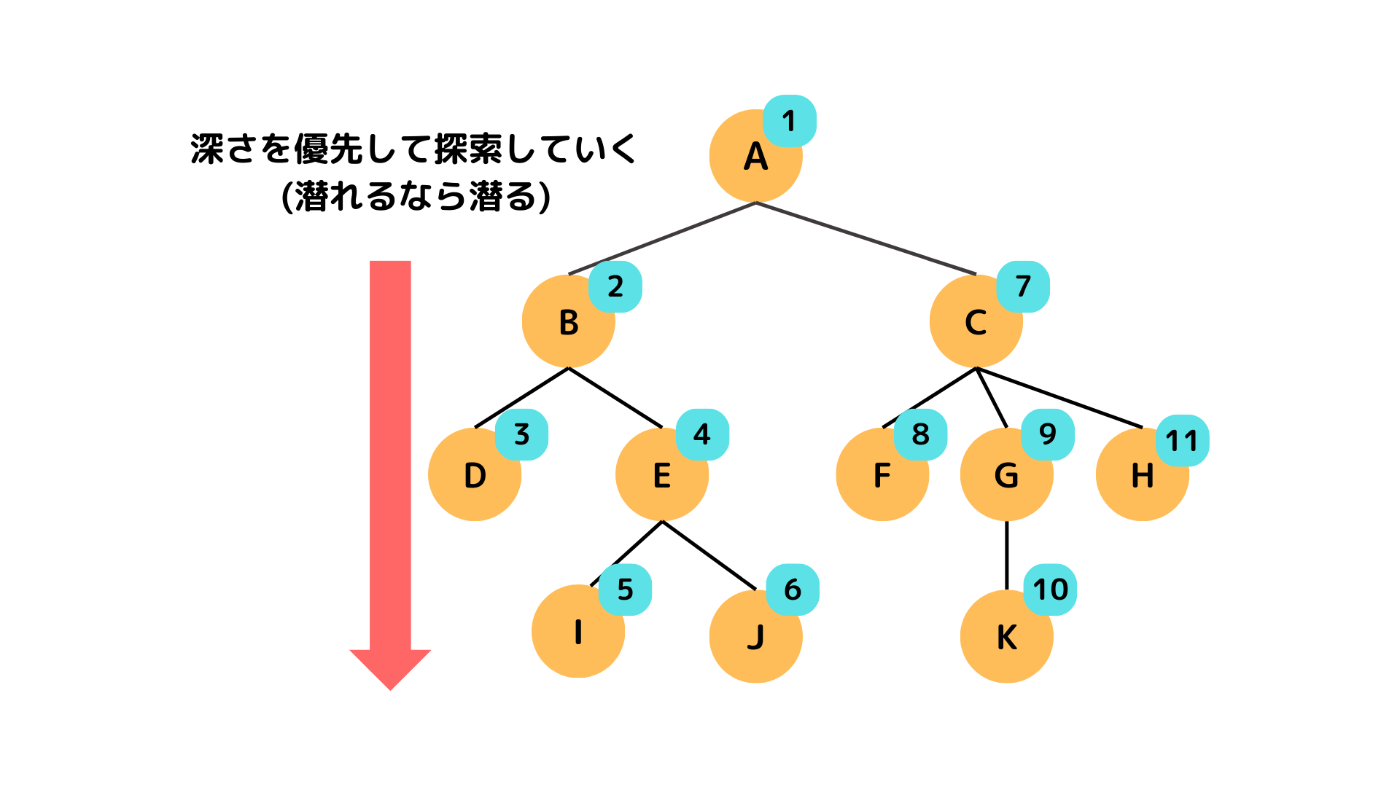
先に示した木構造(tree)をDFSで探索して、全てのノードを出力してみます。
ところで、DFSの実装方法は以下の2種類があります。
- スタックを使う
- 再帰処理を使う
二つそれぞれの実装を見ていきましょう。
スタックを使う
スタックのLIFOという特徴を用いて、ノードの子要素を逆順でスタックに追加して処理していくことで、ノードを深く辿っていくDFSを実現することができます。
スタックとは、データ構造の一つです。特徴として、先入後出し(LIFO:Last In First Out) という点が挙げられます。特徴は読んだそのままですが、よく「本の積み重ね」に例えられます。本を1、2、3冊と重ねていくと最初においた1冊目の本を取り出せるのは最後になります。
参考
この説明だけではさっぱりわからないと思います。コードベースで、処理を図解とともに追っていきましょう。
コード&実行結果
func dfsByStack(root Node) {
	// スタックに格納する要素
	type stackItem struct {
		node  Node
		level int
	}
	// ルートノードをスタックに追加する
	stack := []stackItem{{node: root, level: 0}}

	for len(stack) > 0 {
		// スタックの一番上の要素を取得
		item := stack[len(stack)-1]
		// 深さ(level)を可視化するためにスペースをつける
		for i := 0; i < item.level; i++ {
			fmt.Print("ー")
		}
		fmt.Println(item.node.value)
		// スタックの一番上の要素を削除
		stack = stack[:len(stack)-1]
		// 子ノードをスタックの上に追加していく
		for i := len(item.node.children) - 1; i >= 0; i-- {
			stack = append(stack, stackItem{node: item.node.children[i], level: item.level + 1})
		}
	}
}
出力結果
A
ーB
ーーD
ーーE
ーーーI
ーーーJ
ーC
ーーF
ーーG
ーーーK
ーーH
-
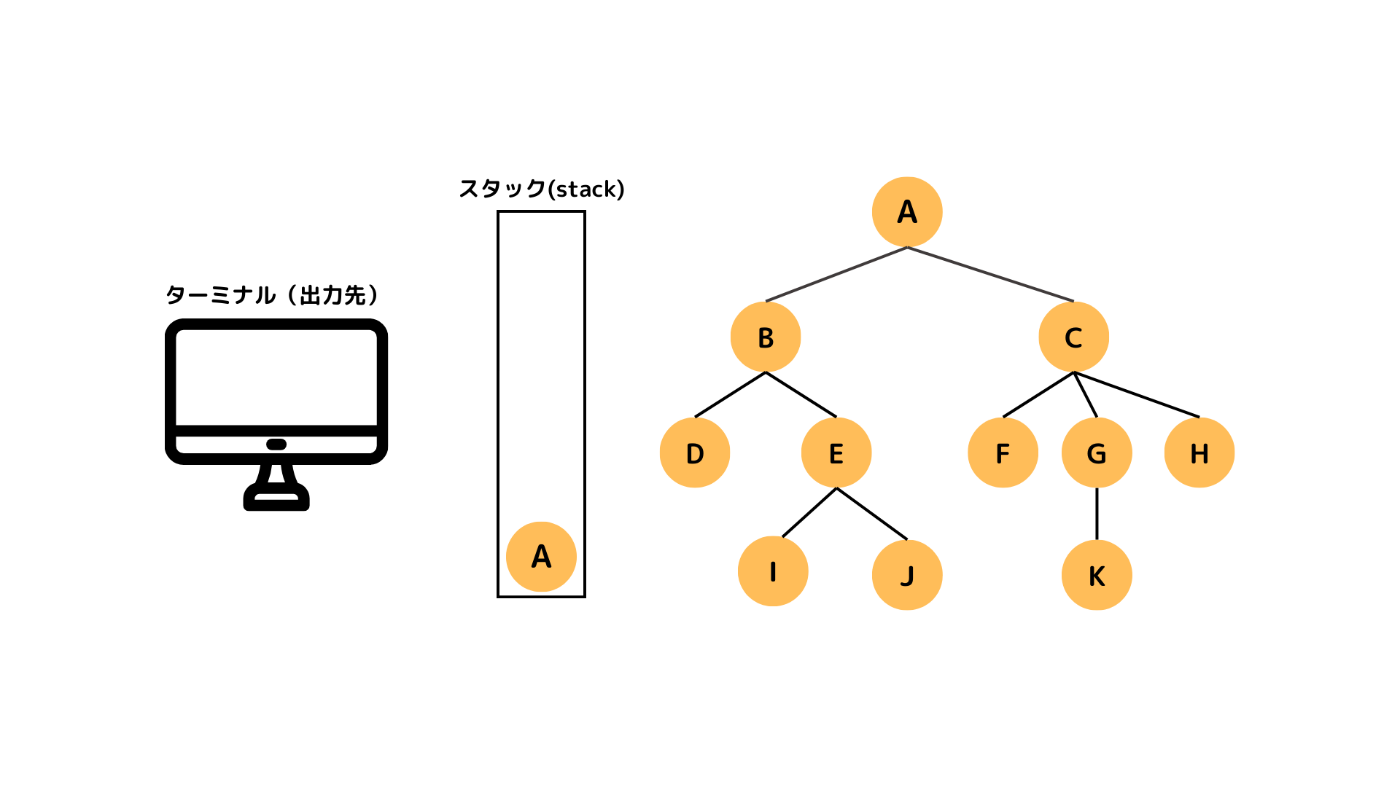
スタックにルートノードを追加する
stack := []stackItem{{node: root, level: 0}}スタックは今このような感じです。
-
スタックの一番上の要素を取得&それを出力&それを取り除く
スタックの一番上の要素を取得し、それを探索します(今回はfmt.Printlnで出力)。そして、その要素はすでに探索済みなのでスタックから削除しておきます。
// スタックの一番上の要素を取得(≒ スライスで言えば一番最後を取得)
item := stack[len(stack)-1]
// 深さ(level)を可視化するためにスペースをつける
for i := 0; i < item.level; i++ {
    fmt.Print("ー")
}
fmt.Println(item.node.value)
// スタックの一番上の要素を削除(≒ スライスで言えば一番最後を削除)
stack = stack[:len(stack)-1]

- 探索した要素の子ノードをスタックの上に追加していく
探索した要素を削除した現状空っぽのスタックに、要素の子ノードを上に追加していきます。スタックをスライスで表現しているので、スライスの一番最後から詰めていくといった感じです。
// 子ノードをスタックの上に追加していく
for i := len(item.node.children) - 1; i >= 0; i-- {
    stack = append(stack, stackItem{node: item.node.children[i], level: item.level + 1})
}
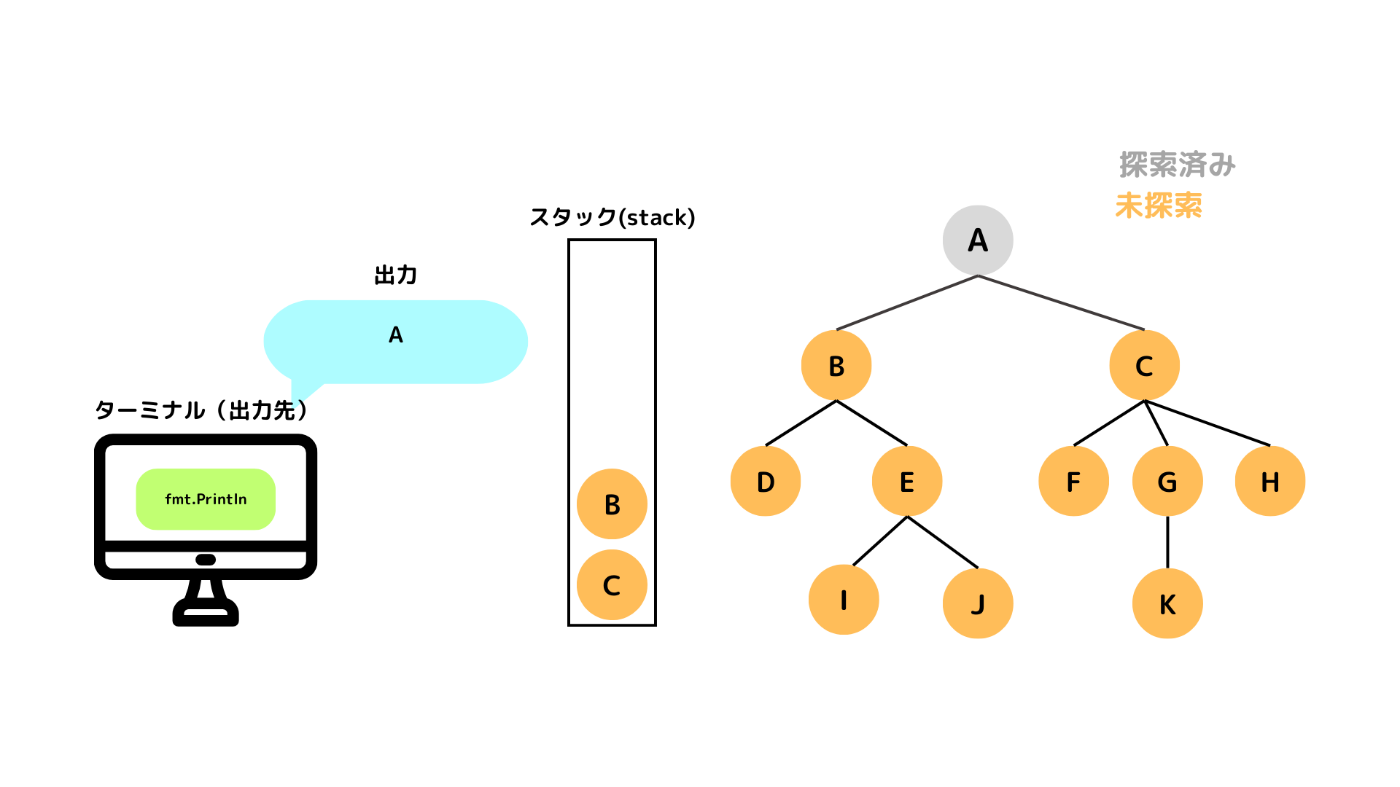
- 2→3の繰り返し
この2→3の流れを、スタックが空になるまで続けていきます。どうなっていくのか、図で処理を追っていきます。
この後は、Bが探索され、スタックから削除されます。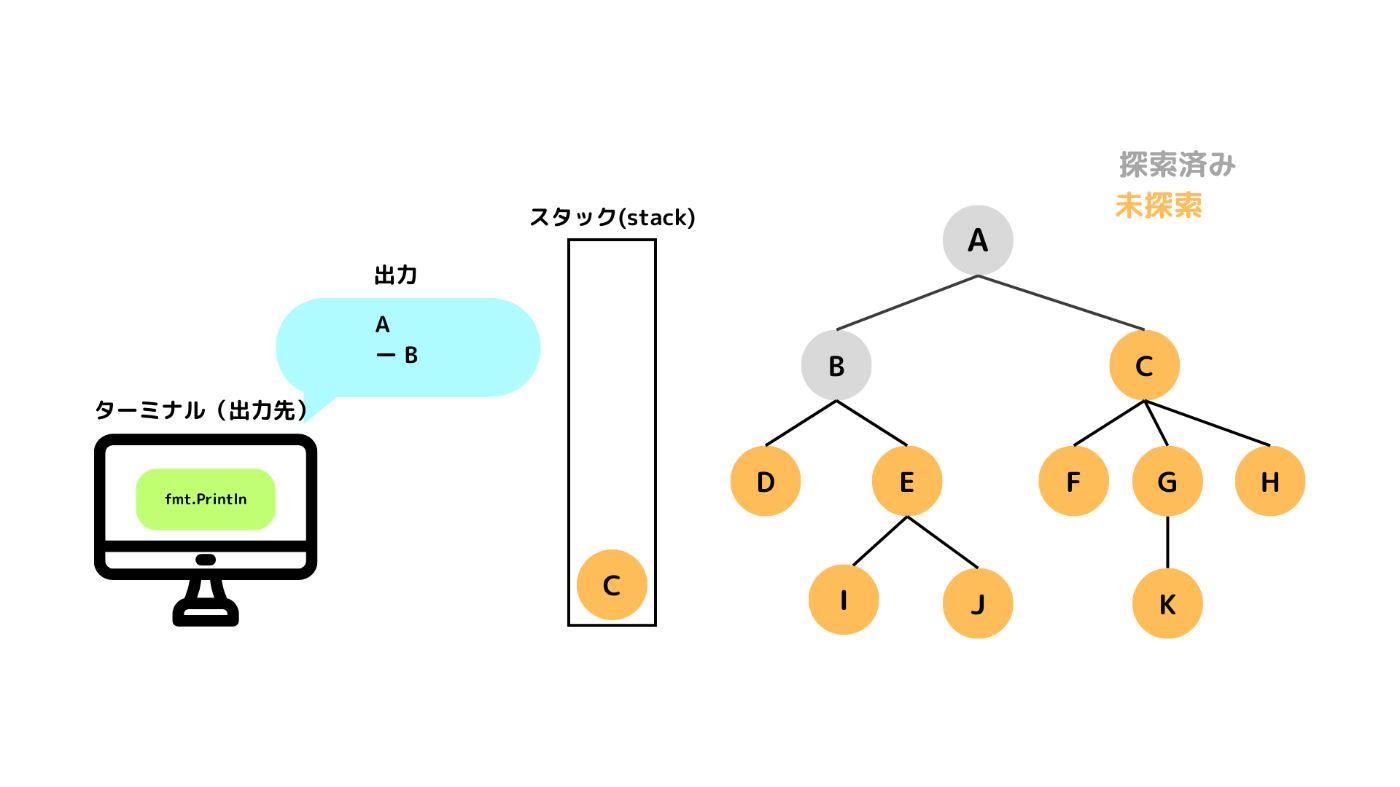
Bの子ノードであるD、Eがスタックに積み重ねられます。
スタックの一番上であるDが探索(出力)され、取り除かれます。
Dには子ノードが存在しないので、ステップ3はスキップされます。
Eは探索(出力)され、スタックから取り除かれます。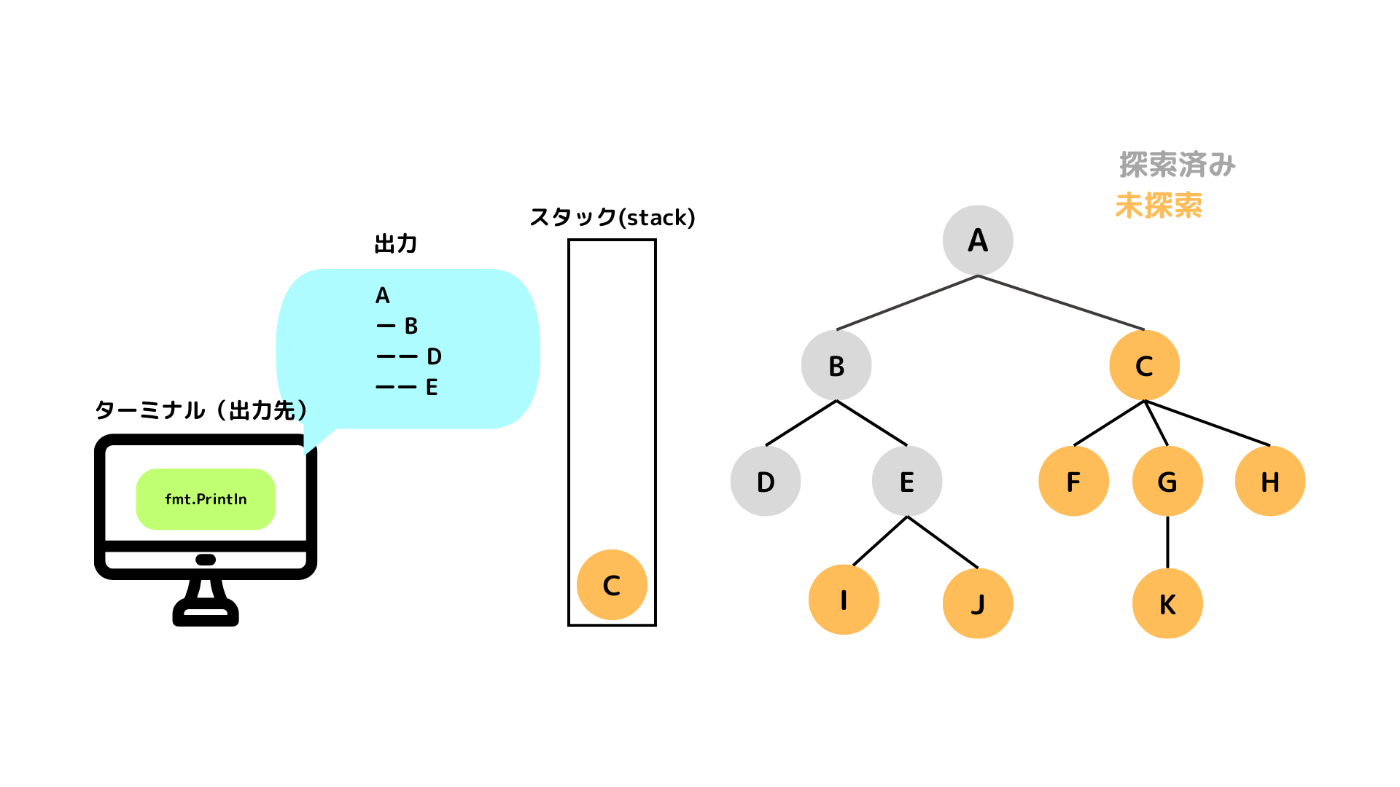
探索したEの要素の子ノードであるI、Jがスタックに積み重ねられます。
I、Jには子ノードが存在しないので、Dの時と同じように探索のみ行われ、スタックから取り除かれます。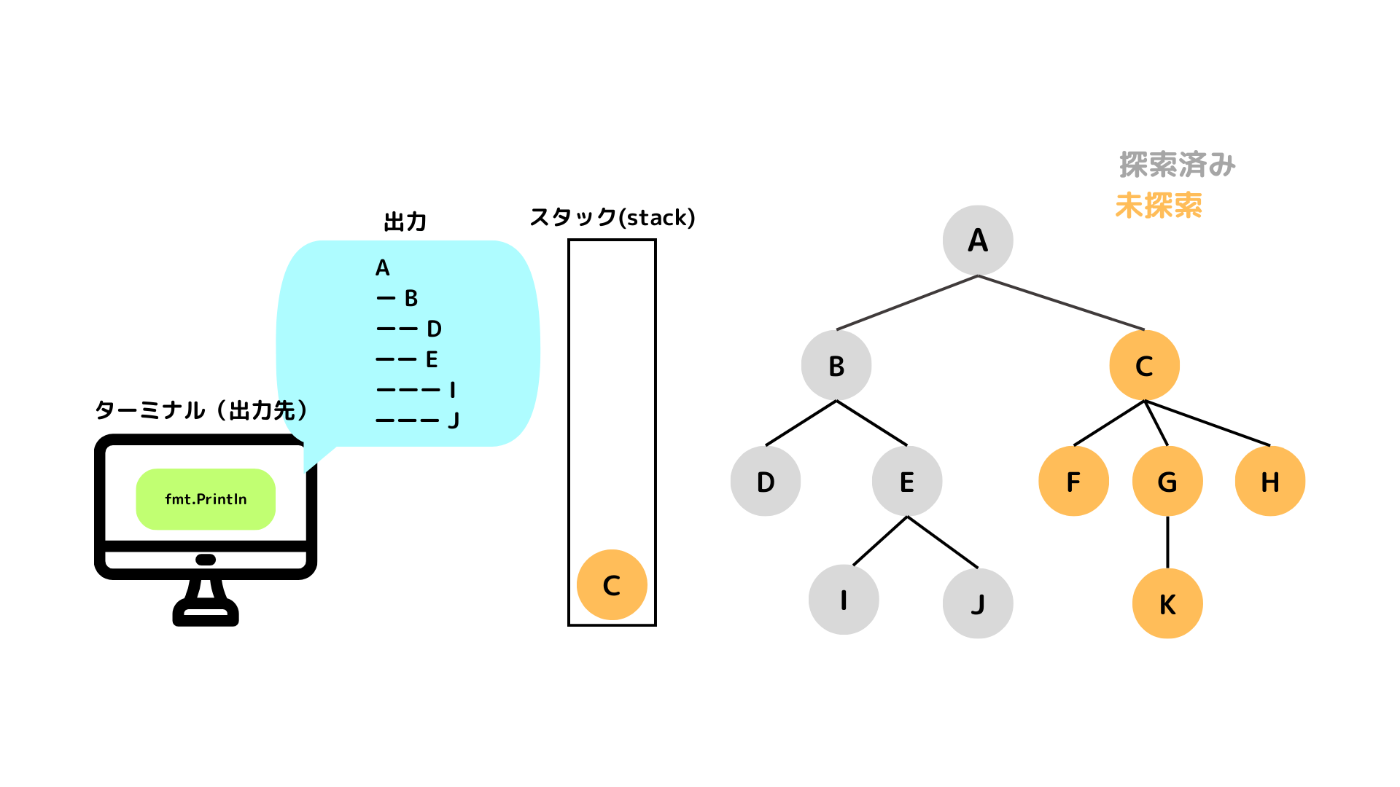
そして、スタックがCのみになります。また、Cが探索され、Cの子ノードが積み重ねられ.....と、同じ処理を繰り返します。
Bから辿れるだけ子ノードを辿って末端まで探索した後、Cのレベルまで戻り、また再び探索をしていくという動きを確認できたかと思います。
再帰処理
同じように、再帰処理を使ってDFSを行うことも可能です。コードを見てみると、要素の子ノードの数だけ再帰的に処理を行っていることがわかります。
コード&実行結果
func dfsByRecursive(node Node, level int) {
	// 深さ(level)を可視化するため
	for i := 0; i < level; i++ {
		fmt.Print("ー")
	}
	// 現在のノードの値を表示
	fmt.Println(node.value)
	// 子ノードがある場合は再帰的に処理を繰り返す
	// つまり、深く深く進んでいく
	for _, child := range node.children {
		dfsByRecursive(child, level+1)
	}
}
実行結果
A
ーB
ーーD
ーーE
ーーーI
ーーーJ
ーC
ーーF
ーーG
ーーーK
ーーH
先のスタックを用いたDFSと何が違うのでしょうか。
実は、「再帰処理を使ったDFS」も「スタックを使ったDFS」と同じ動作をしています。
これを理解するには、内部でコールスタックを使っていることを知る必要があります。
コールスタックとは、「関数呼び出し」の積み重ねと捉えてください。呼び出された関数がスタックの一番上に積み重ねられ、関数の処理が終わるとスタックから取り除かれます。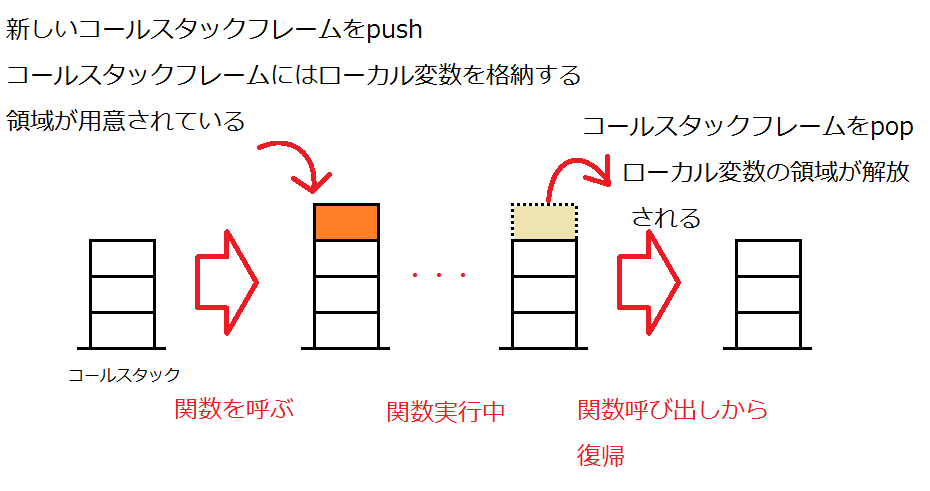 (JavaScriptによるJavaScript実装(いで@いで庵)より引用)
先の、スタックを使ったDFSとほぼ同じ原理と考えてイメージしてみてください。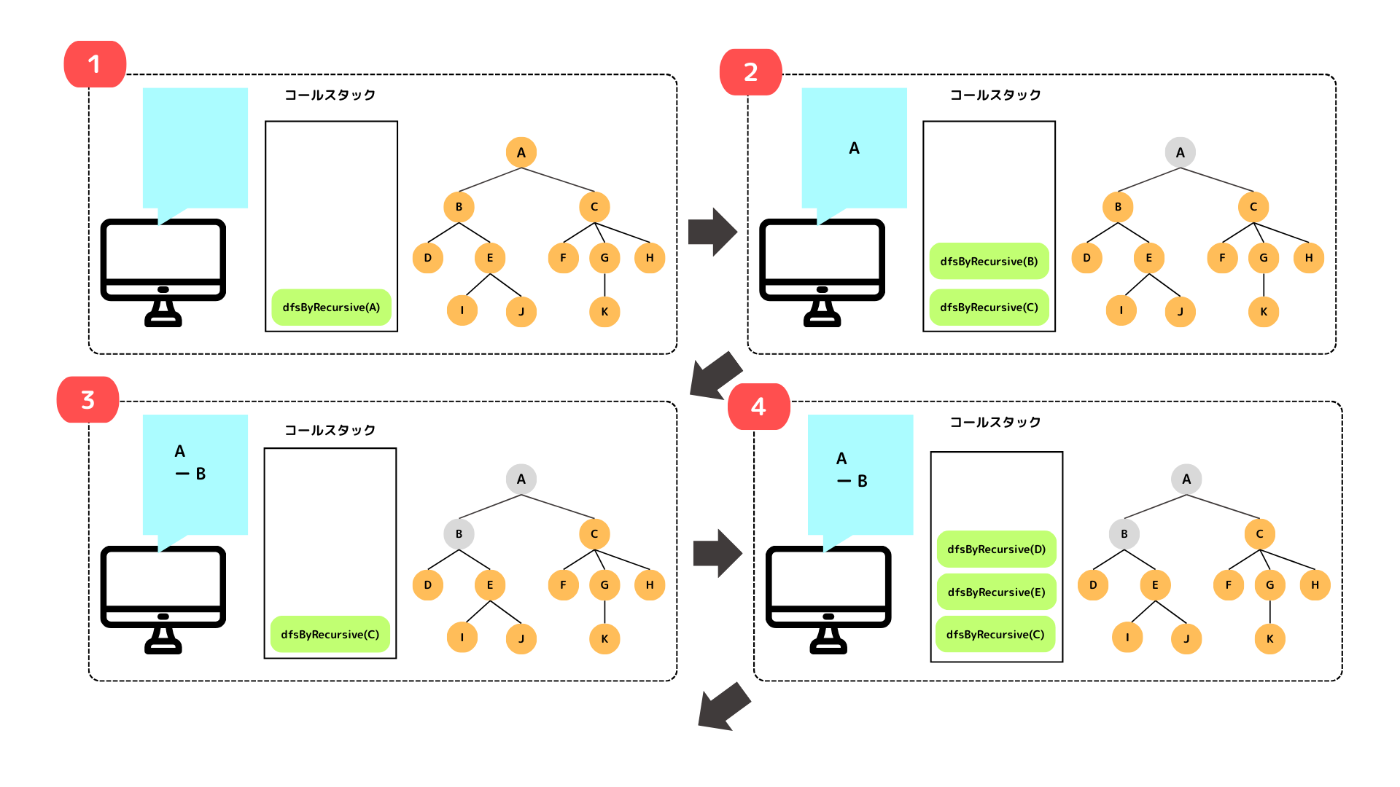

コール「スタック」に要素(≒関数呼び出し)を順に積み上げて、探索済み(≒呼び出しから復帰)の要素はスタックから取り除く、そしてその子ノード(再帰関数)をまたスタックに積み上げる....を繰り返します。
細かく分類すると、深さ優先探索には、前順/間順/後順 の3つの種類がありますが、今回は「前順」を扱っています。詳しくは、こちらの記事をご覧ください。
幅優先探索(BFS)
BFS・・・すなわち、Breadth-First Searchのことです。ざっくり言えば、
同じ階層を全て調べてから次の深さに進んでいくのを繰り返す
探索法です。
DFSとは打って変わって、浅くみていく探索方法です。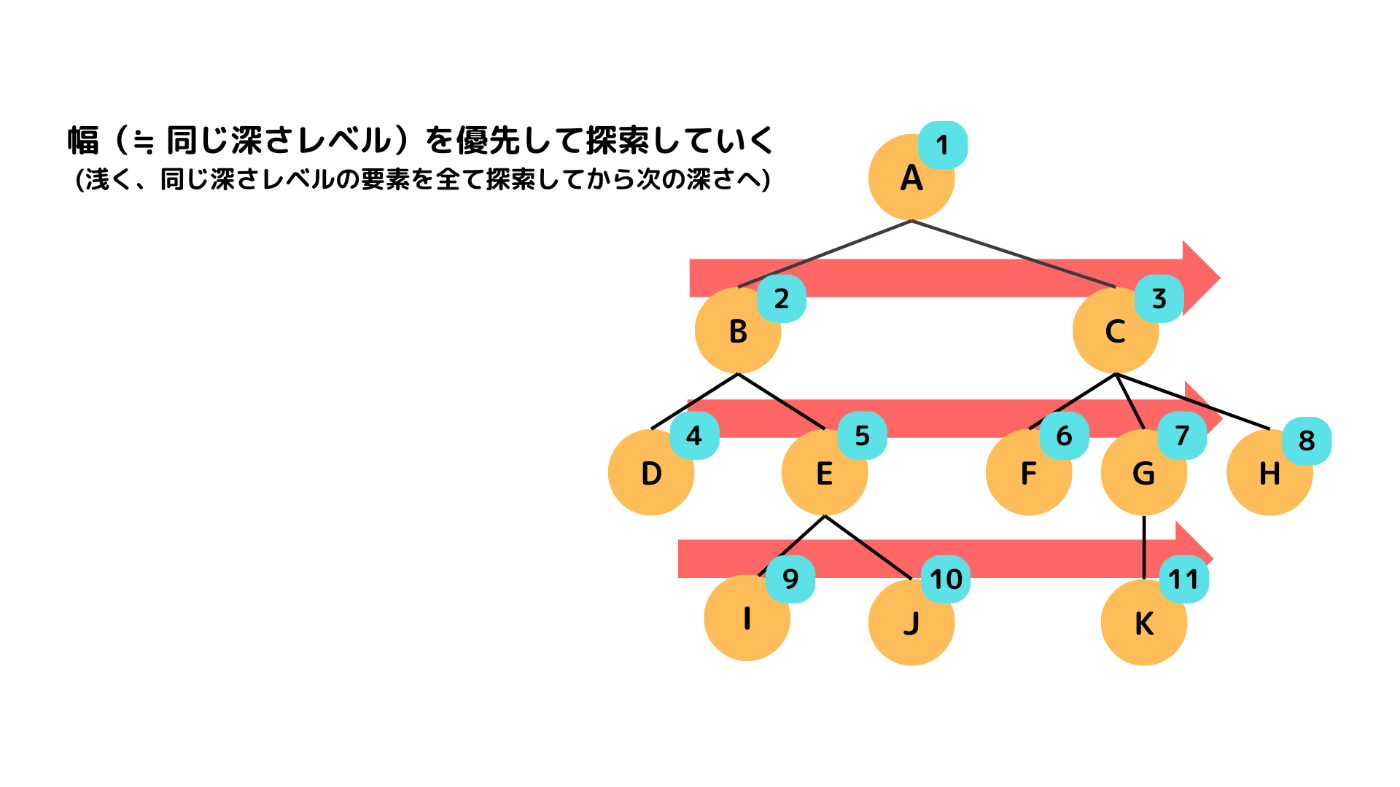
先で使用した多分木(tree)を使って、BFSの処理ををコードベース&図解で追っていきます。
BFSの実装には、主に「キュー」が使われているようなのでその一点のみ見てみましょう。
キュ️ーを使う
キューの FIFOという特徴を用いて、同じ深さレベルの子ノードから順番に探索していく BFS を実装することができます。
キューは、スタックと同じくデータ構造の一つです。特徴として先入先出(FIFO:First In First Out) という点が挙げられます。これも特徴は読んでそのままですが、よく「待ち列」に例えられます。アイドルの握手会に先に並んだ人は、先に握手できます。
参考
treeをBFSで探索して、全てのノードを出力してみます。
コード&実行結果
func bfsByQueue(root Node) {
	// キューに格納する要素
	type queueItem struct {
		node  Node
		level int
	}
	// ルートノードをキューに追加する
	queue := []queueItem{{node: root, level: 0}}

	for len(queue) > 0 {
		// キューの先頭の要素を取得
		item := queue[0]
		// 深さレベルを可視化するため
		for i := 0; i < item.level; i++ {
			fmt.Print("ー")
		}
		fmt.Println(item.node.value)
		// キューの先頭の要素を削除
		queue = queue[1:]
		// 子ノードをキューに追加していく
		for _, child := range item.node.children {
			queue = append(queue, queueItem{node: child, level: item.level + 1})
		}
	}
}
出力結果
A
ーB
ーC
ーーD
ーーE
ーーF
ーーG
ーーH
ーーーI
ーーーJ
ーーーK
-
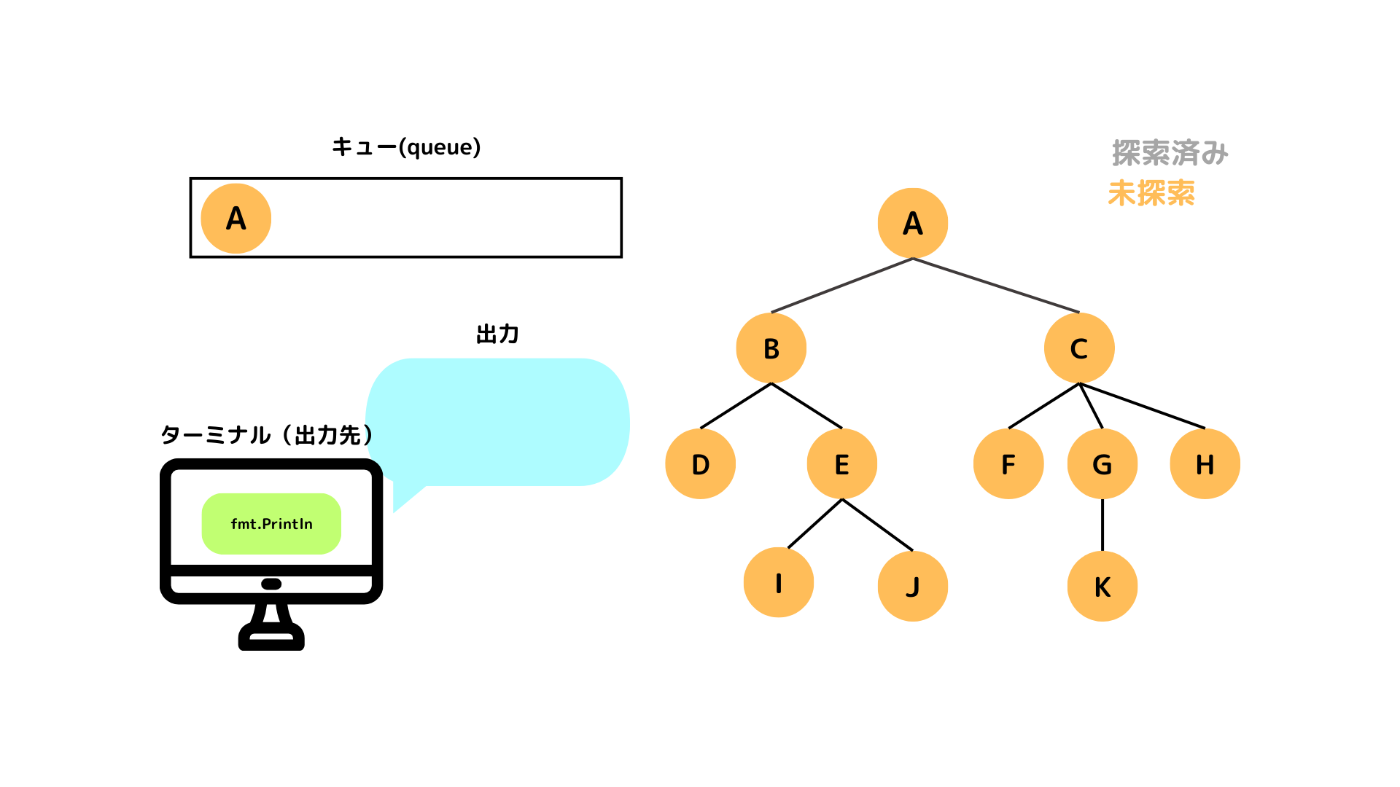
キューの先頭にルートノードを追加する
 // ルートノードをキューに追加する
 queue := []queueItem{{node: root, level: 0}}
キューは今以下のようにAが追加されている状態です。
-
キューの先頭の要素を取得&それを出力&それをキューから取り除く
// キューの先頭の要素を取得
item := queue[0]
// 深さレベルを可視化するためにスペースをつける
for i := 0; i < item.level; i++ {
    fmt.Print("ー")
}
fmt.Println(item.node.value)
// キューの先頭の要素を削除
queue = queue[1:]
スタックはLIFOだったので最後に追加された要素から探索が行われ、取り除かれていました。しかし、キューはFIFOなので、それとは反対に最初(先頭)の要素から探索(今回は
fmt.Printlnで出力)します。そして、その要素を探索済みとしてキューから取り除きます。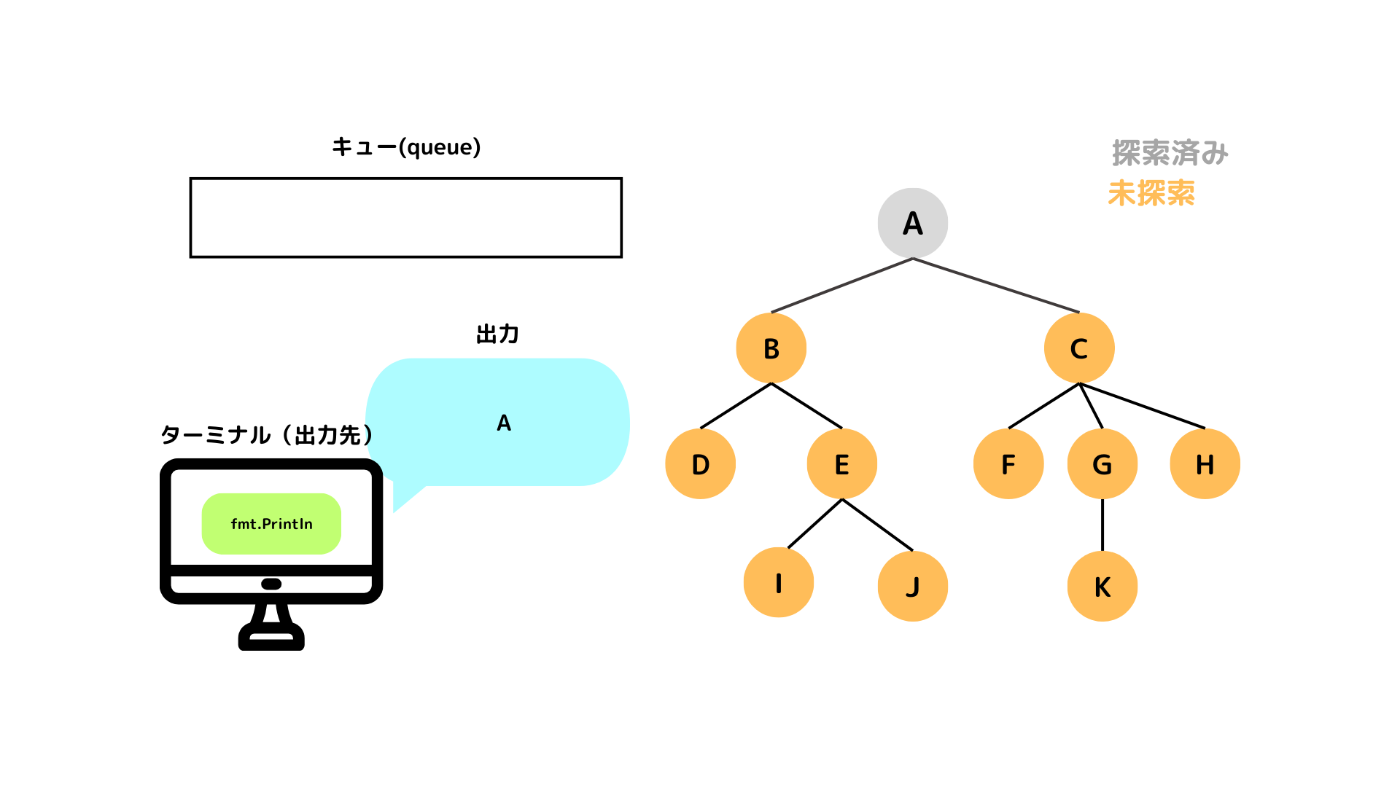
-
探索した要素の子ノードをキューに追加していく
// 子ノードをキューに追加していく
for _, child := range item.node.children {
    queue = append(queue, queueItem{node: child, level: item.level + 1})
}
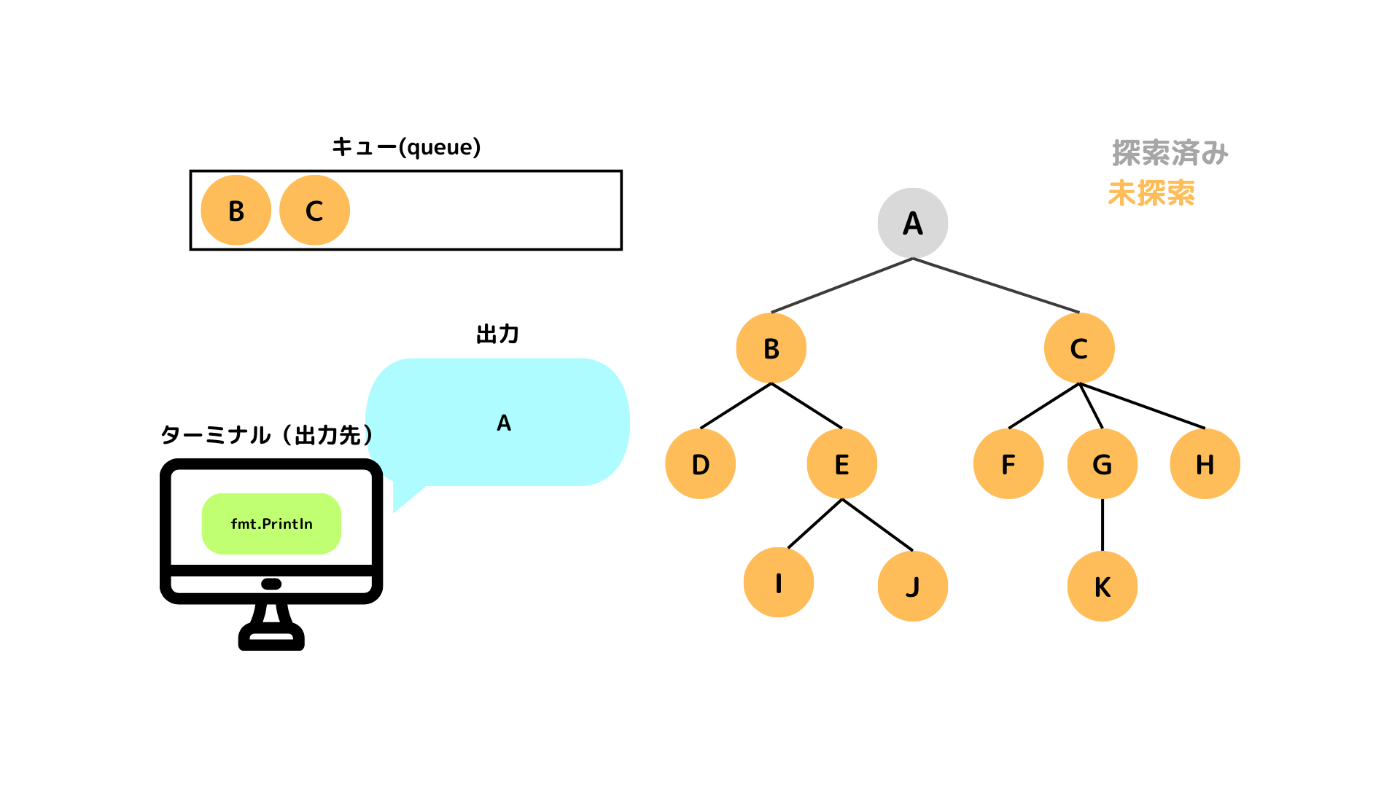
探索したAの子ノードであるB、Cを順番にキューに追加(エンキュー)していきます。
-
2→3の繰り返し この2→3の流れを、キューが空になるまで続けていきます。どうなっていくのか図解で処理を追っていきます。
この後は、キューの先頭であるBが探索され、キューから取り除かれます。
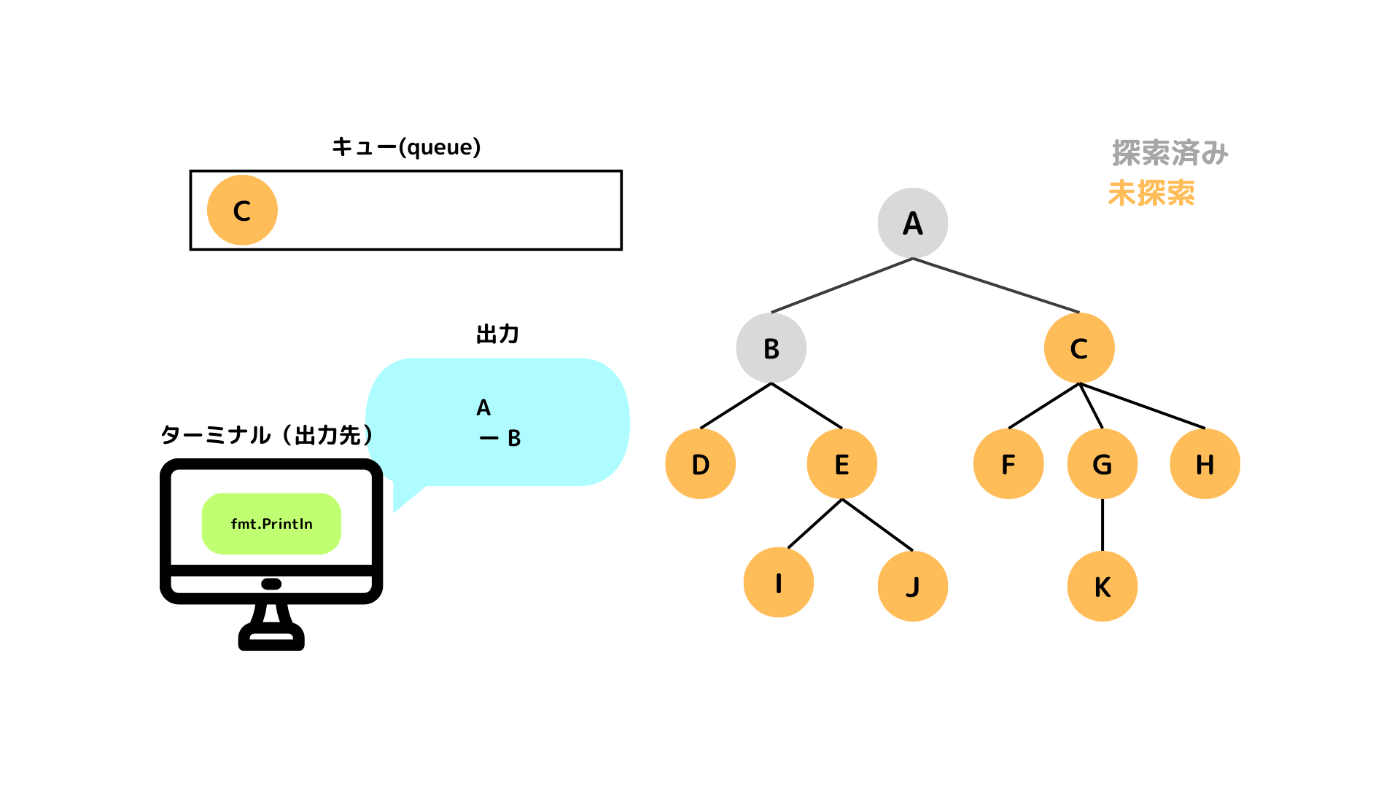
そして探索されたBの子ノードであるD、Eが順番にキューに追加されます。
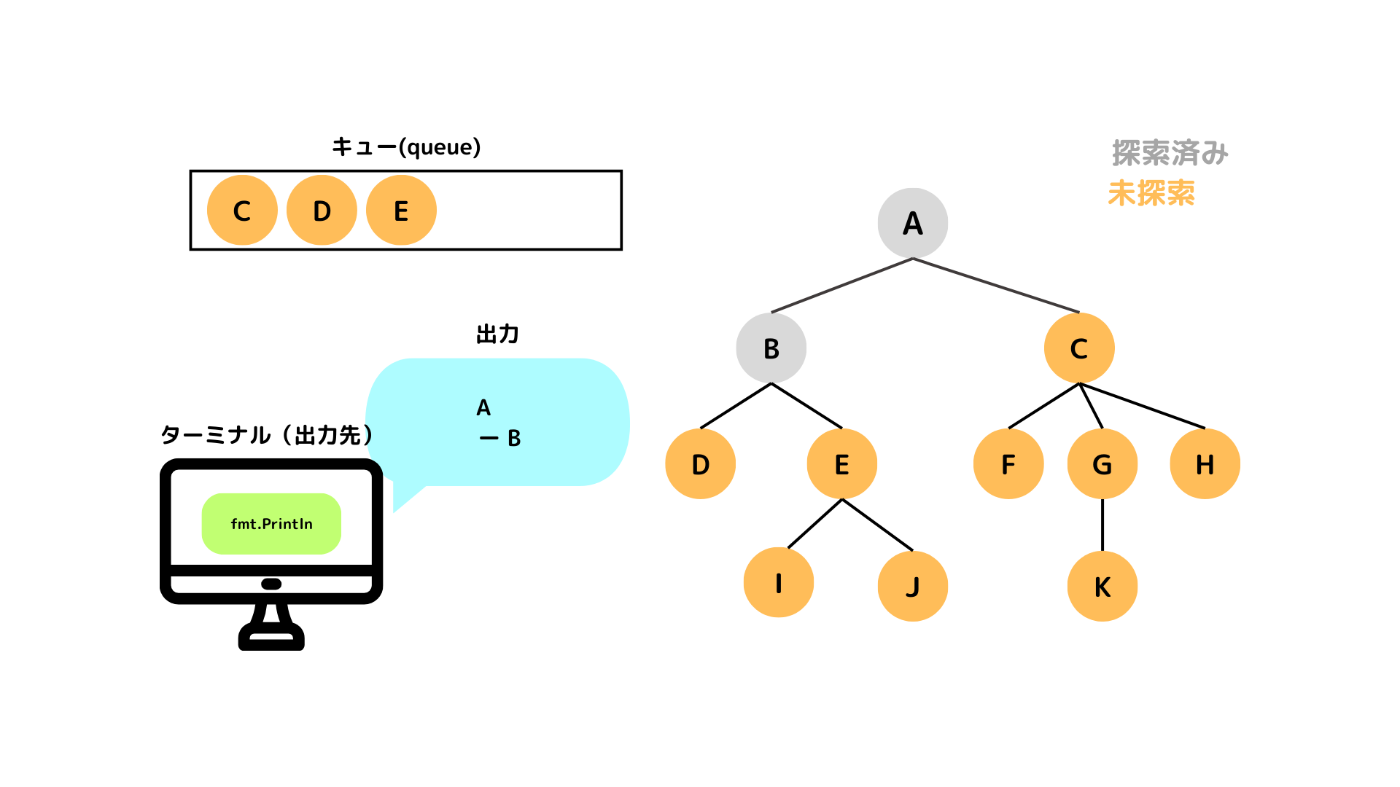
キューの先頭であるCが探索され、キューから取り除かれます。
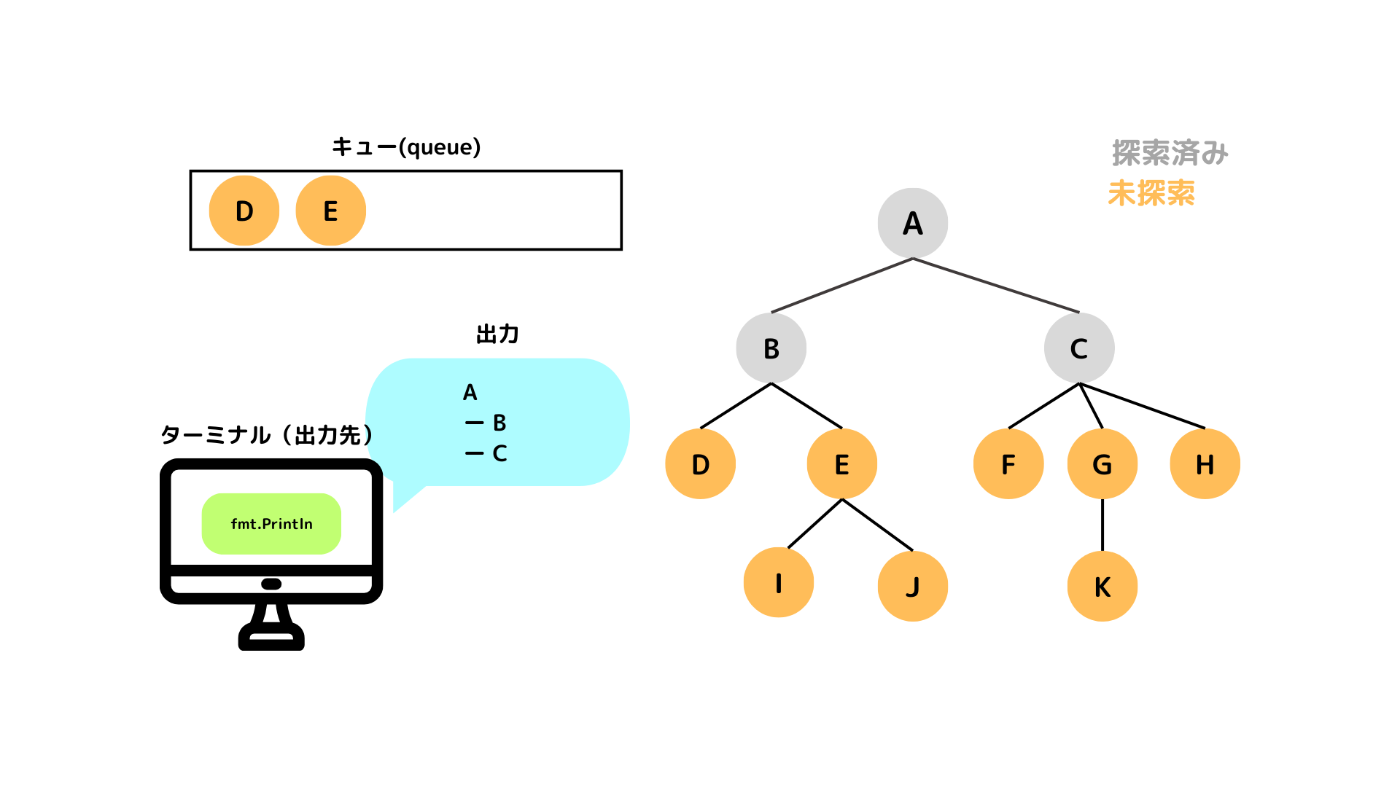
探索したCの子ノードである、F、G、Hがキューに追加されます。
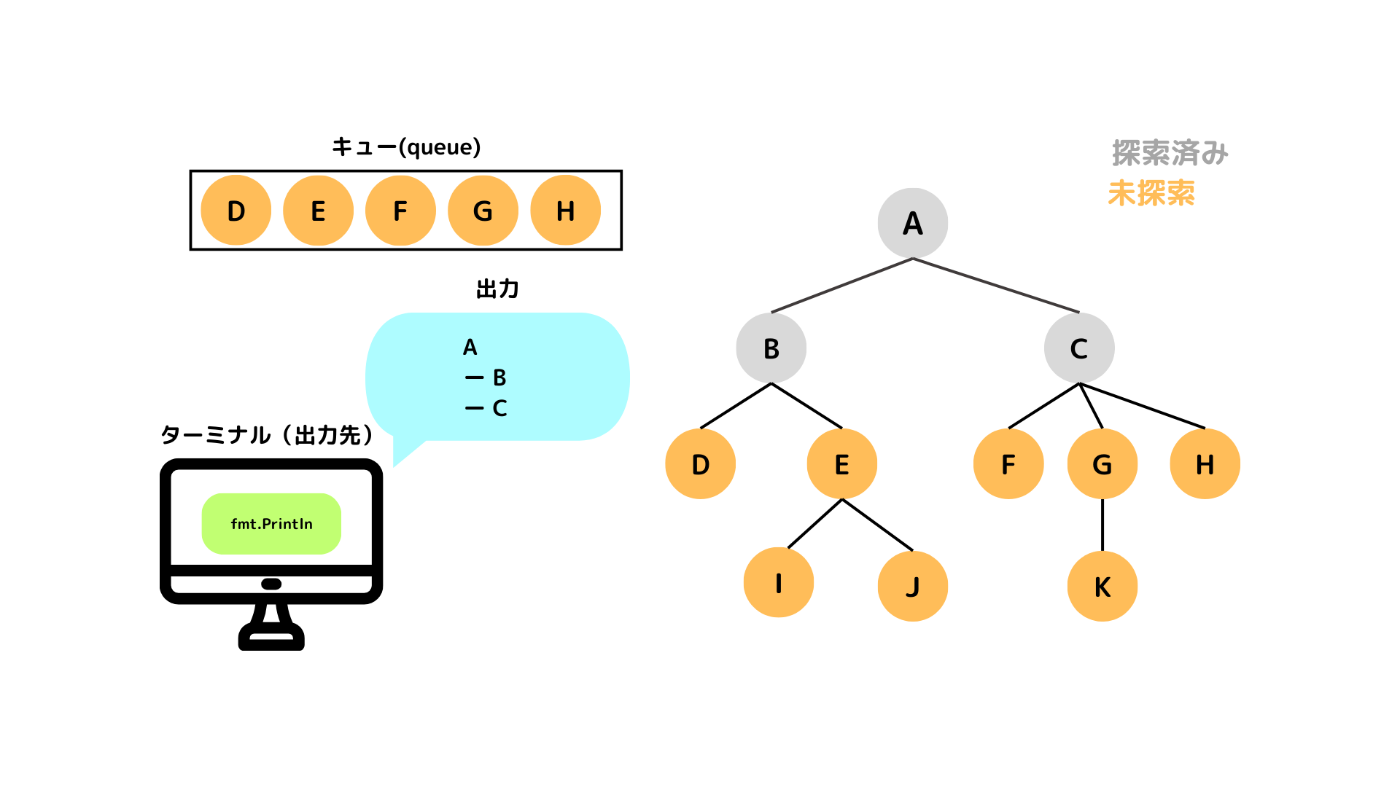 先頭であるDが探索され、キューから取り除かれます。Dには子ノードが存在しないので、ステップ3はスキップされます。
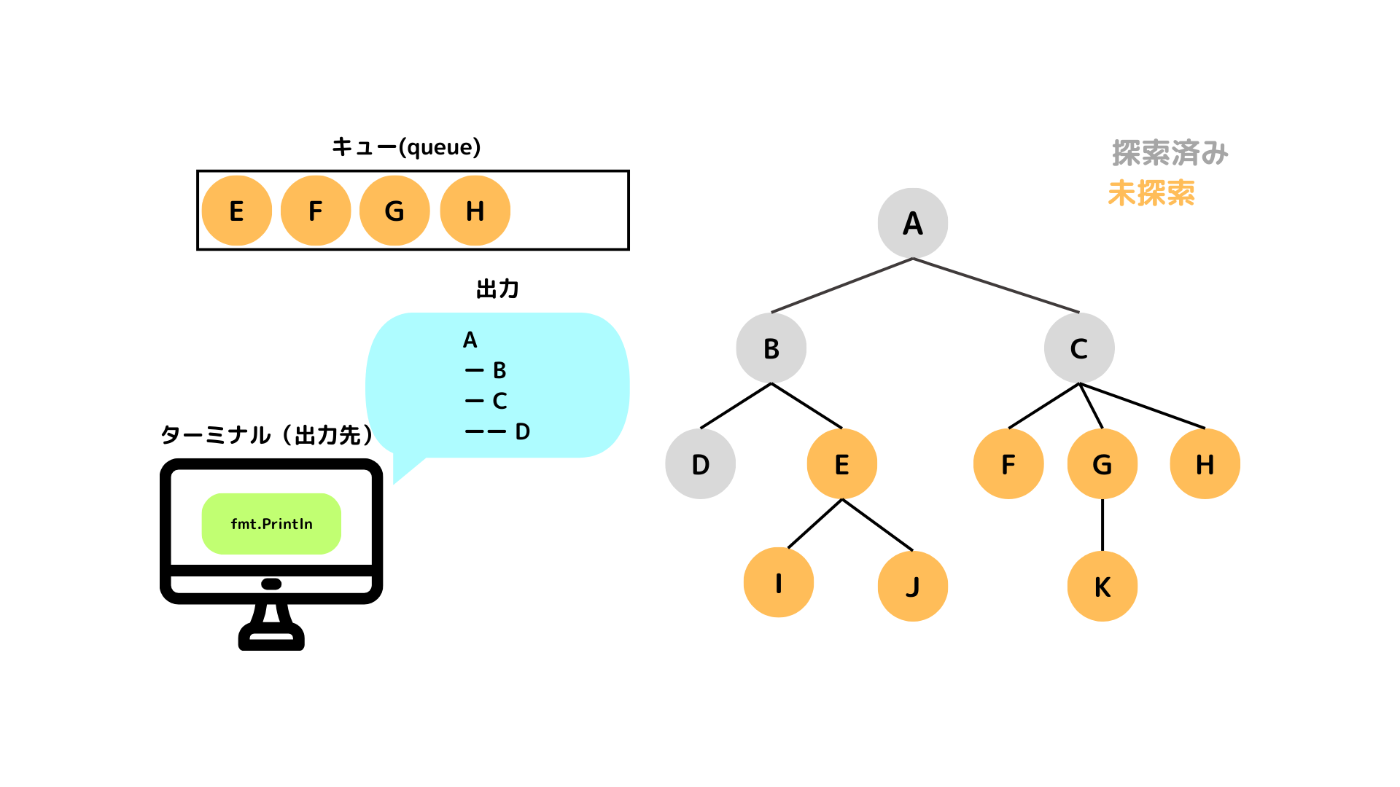 先頭であるEが探索され、キューから取り除かれます。
 そして、探索されたEの子ノードであるI、Jがキューに追加され、次にキューの先頭であるFが探索されて....といった風に処理が続いていきます。
DFSの時とは違って、同じ深さレベルの要素を全て探索してから次の深さを探索していくという動きを確認できたかと思います。
ユースケース(スクレイピング)で考える
DFS、BFSの動きを理解はできても、それの活用法を知らなければ、机上の空論感があります。活用法はさまざまで、調べれば大量に出てきます。
本記事では、スクレイピングにおける二つの例を用意して、DFSとBFSを活用していきます。
例:文字情報を全て取ってくる
以下のようなサイトが仮にあったとして、HTTPリクエスト→レスポンスボディからHTMLファイルを抽出→パースしてスクレイピングという流れを考えます。今回は、HTMLファイルを自前で用意して、それをパースさせることにします。
以下のようなサイトを想定します。
HTMLファイル
<html>
  <head>
    <title>kakkky - Portfolio</title>
  </head>

  <body>
    <div>
      <h1>Hello,There👋</h1>
      <p>
        これは、kakkkyのポートフォリオページです。ここでは、私のプロジェクトや経験について紹介します。
      </p>
      <p>
        時々Zennにて記事を執筆しています。興味のある方は、ぜひご覧ください。
        <a href="https://zenn.dev/yuta_kakiki">kakkkyのZenn記事をみる</a>
      </p>
    </div>
    <div>
      <h2>プロフィール</h2>
      <div>
        <h3>出身地</h3>
        <p>奈良県</p>
      </div>
      <div>
        <h3>趣味</h3>
        <p>音楽を聴く</p>
      </div>
    </div>
  </body>
</html>
HTMLファイルは、DOMツリーによって構成されています。上のHTMLファイルをツリー構造で表せば、以下のようになります。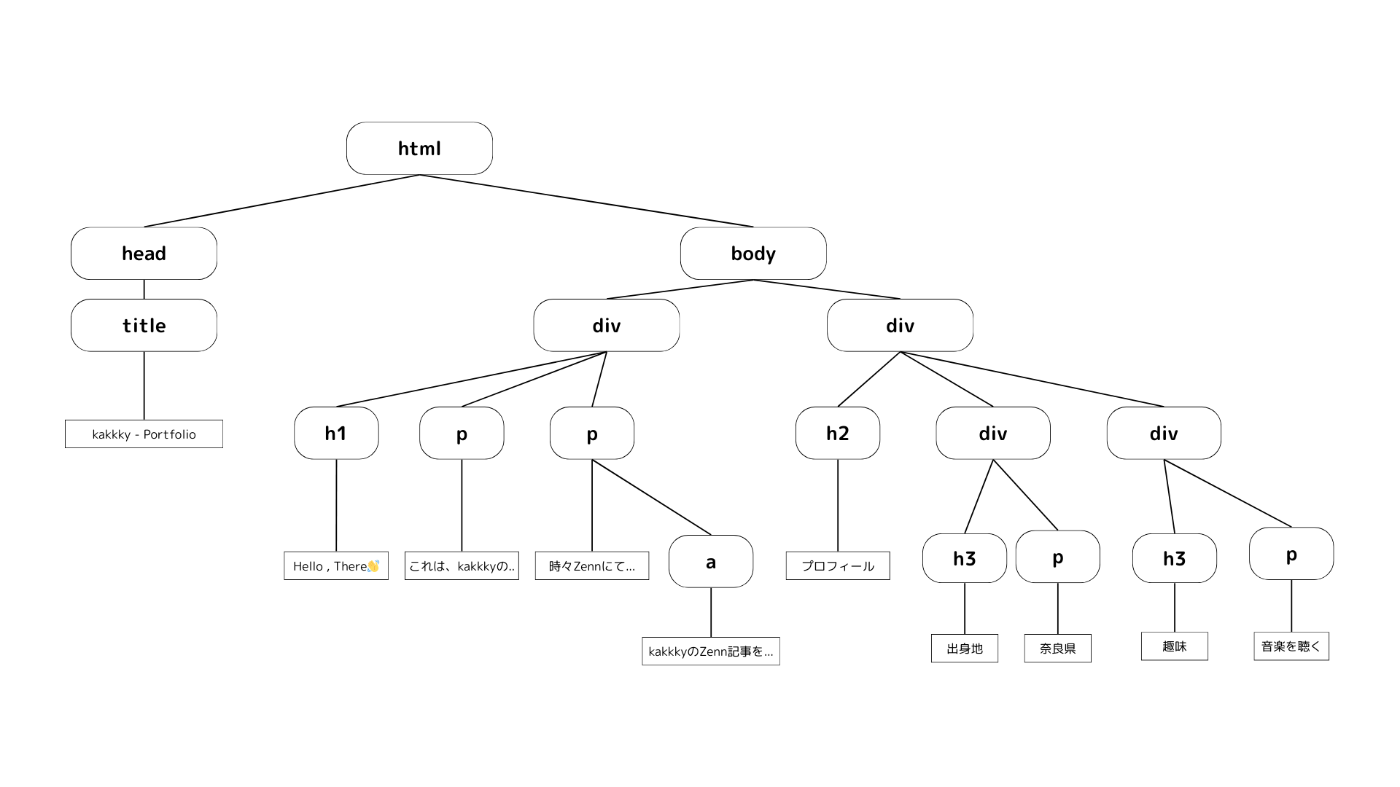
文字情報を全て出力するというのは、つまり、ツリーの図でいう四角で囲まれた部分を全て取ってくるということです。そして、文字の出力するといっても、順番がバラバラだと困るので、サイトに表示されている順序としたいです。
❓ この場合、DFSとBFSのどちらを使うのが良さそうでしょうか。
筆者は、今回のケースでは DFSを使った方が自然 だと考えています。その理由は、HTMLの構造(DOMツリー)と、それを描画するブラウザの仕組みに由来します。
たとえばHTMLでは、<div> や <p> の中に文字や他のタグをネストして構造化することがよくあります。このネスト構造は、そのまま ツリー構造の「親→子」関係(ノードの階層構造) に対応します。
実際、WebページをHTMLで書いていく時は以下のように考えることが多いはずです。
-
意味ごとに区切って
<div>で囲む -
セクションごとに要素をネストする
-
スタイルの対象を限定するためにネストを深くする
こうした記述は、HTMLとしては深くネストされる構造(つまり多分木な木構造)になりますが、ユーザーがページを読むときには、上から下へ、論理順に読んでいきます。
先のツリー構造は、以下のようにも表せます。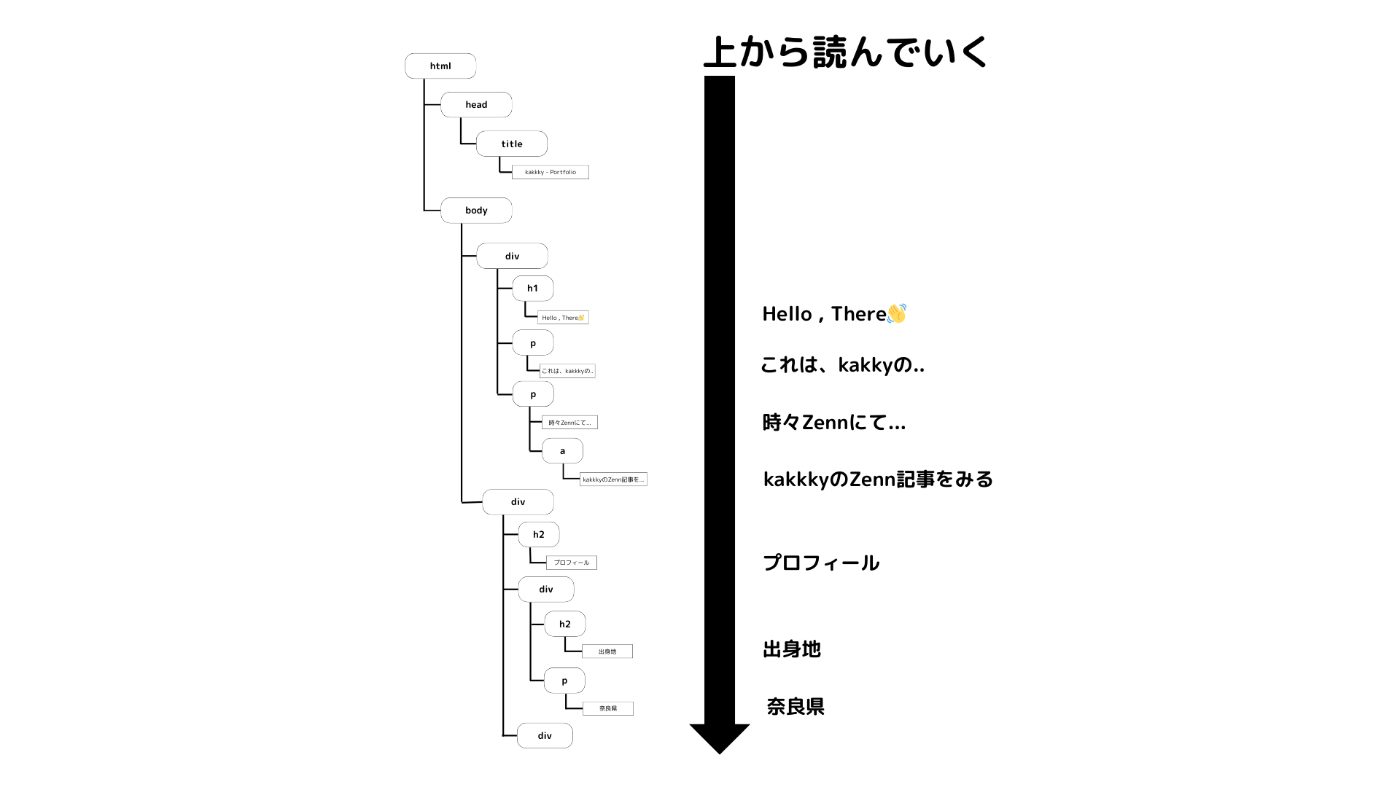
つまり、
「ネストが深くても、視覚的な読み順は一方向(縦方向)」
ということです。
このような構造に対しては、一つの要素を掘り下げて(深く潜って)から次へ進む、つまり DFSの方が、人間の視点での「読み順」に近い形で巡回できます。
実装したコードは以下の通りです。
コード& 実行結果
//go:embed index.html
var htmlFile []byte

func scrapeAllSentences(node *html.Node) {
	// テキストノードのみを表示
	if node.Type == html.TextNode {
        // スペースは削除して出力
		fmt.Println(strings.TrimSpace(node.Data))
	}
	// 子ノードに対して再帰処理を行う
	for c := node.FirstChild; c != nil; c = c.NextSibling {
		scrapeAllSentences(c)
	}
}

func main() {
	// バイトスライスのHTMLファイルをパースしてDOMツリーにする
	tree, _ := html.Parse(bytes.NewReader(htmlFile))
	// DOMツリーを走査して、テキスト情報を出力
	scrapeAllSentences(tree)
}
実行結果
kakkky - Portfolio


Hello,There👋

これは、kakkkyのポートフォリオページです。ここでは、私のプロジェクトや経験について紹介します。

時々Zennにて記事を執筆しています。興味のある方は、ぜひご覧ください。
kakkkyのZenn記事をみる


プロフィール


出身地

奈良県


趣味

音楽を聴く
しっかり読み順で取得することができました。
このように、DFSは
- 全てのノードを探索する必要がある場合
- 木構造の中でノードの順序が意味を持つ場合
に有効な探索アルゴリズムと言えるでしょう。
BFSで実装すると
もし、これを単純にBFSに書き換えた場合の出力は以下のようになります。みてみると、期待しない順序で取得されていることがわかります。これは、同じ深さレベルのノードを全て探索してから次の深さに進むという順序が、DOMツリーの勝手と異なるからです。
kakkky - Portfolio


Hello,There👋
これは、kakkkyのポートフォリオページです。ここでは、私のプロジェクトや経験について紹介します。
時々Zennにて記事を執筆しています。興味のある方は、ぜひご覧ください。

プロフィール


kakkkyのZenn記事をみる
出身地
奈良県
趣味
音楽を聴く
例:<title>タグの情報をとってくる
同じWebサイトを例に、他のケースを考えましょう。 Webページに記載されている、タイトル情報を文字列で出力したいというケースです。
タイトルは、すなわち<title>タグに囲まれている情報のことです。
❓この場合、DFSとBFSのどちらを使うのが良さそうでしょうか。
筆者は、BFSを使った方が自然だと考えています。
その理由は、<title>はDOMツリーの浅い階層に存在することが自明だからです。
基本、以下のように<title>は<head>の中に書かれます。
<html>
  <head>
    <title>kakkky - Portfolio</title>
  </head>
  <body>
    ・
    ・
BFSでは、ルートに近いノードから順に探索していきます。そのため、最短で<title>に辿り着く可能性が高いと考えられます。

この例だと、DFSなら3手で行けるじゃん、って思われるかもしれませんが、これはあくまで例です。例えば、<head>よりも先に<body>が記述されていた場合を考えてください。headの子ノードの探索は、bodyを深く深く探索した後になってしまいます。
そういうわけで、BFSで実装すると以下のようになりました。
コード&実行結果
func scrapeTitle(node *html.Node) {
	// キューに格納する要素
	type queueItem struct {
		node  *html.Node
		level int
	}
	// ルートノードをキューに追加する
	queue := []queueItem{{node: node, level: 0}}

	for len(queue) > 0 {
		// キューの先頭の要素を取得
		item := queue[0]
		// タイトルタグを見つけたら、その子ノード(テキスト)を出力し、処理を終了
		if item.node.DataAtom == atom.Title {
			fmt.Printf("Title: %s\n", item.node.FirstChild.Data)
			break
		}
		// キューの先頭の要素を削除
		queue = queue[1:]
		// 子ノードをキューに追加していく
		for c := item.node.FirstChild; c != nil; c = c.NextSibling {
			queue = append(queue, queueItem{node: c, level: item.level + 1})
		}
	}
}

func main() {
	// バイトスライスのHTMLファイルをパースしてDOMツリーにする
	tree, _ := html.Parse(bytes.NewReader(htmlFile))
	// DOMツリーを走査して、テキスト情報を出力
	scrapeTitle(tree)
}
出力結果
Title: kakkky - Portfolio
このように、BFSは、
-
目的のノードが浅い階層にある場合
-
探索対象のノードがどの深さにあるか不明で、できるだけ早く見つけたい場合
に有効な探索アルゴリズムであると言えるでしょう。
おわりに
今回は、DFSとBFSについてを、コード&図解&ユースケースを用いて解説してみました。
こういったアルゴリズムはぱっと見複雑な処理が多いですが、書き出してみて整理してみたり、実際の活用法を知って実装してみたりしないと個人的には理解しづらいなぁと思いました。
CS初心者なので、これからはこういった形で理解を深めていこうと思います。
(精進)