はじめに
個人的な興味として、Kubernetes のネットワークについて調べてみました。
k8sのネットワークについて調べていくと、Linuxカーネルについて調べる必要も出てきてその点が面白かったので、記事としてまとめておきたいと思います。
実際にKindクラスター(ローカルでk8sクラスターを立てられるやつ)も覗いてみたりもしてみました。
大体以下の流れで見ていきます。
- Service が Pod 群に対する通信の抽象レイヤーとして機能する仕組み (Service / EndpointSlice)
- Service への通信が実際に Pod に届くまでの仕組み (kube-proxy / iptables / netfilter)
- Pod のネットワークが組み立てられる仕組み (CNI / netns / veth)
Pod 群への通信を抽象化するService
Pod内のコンテナはループバック経由(localhost)での通信が可能です。そして、Podはクラスタ内でユニークなIPアドレスを持っています。つまり、Pod間は通信が可能ということになります。
そこで、あるPod-Aから、Pod-Bにアクセスしたいという状況を考えてみます。
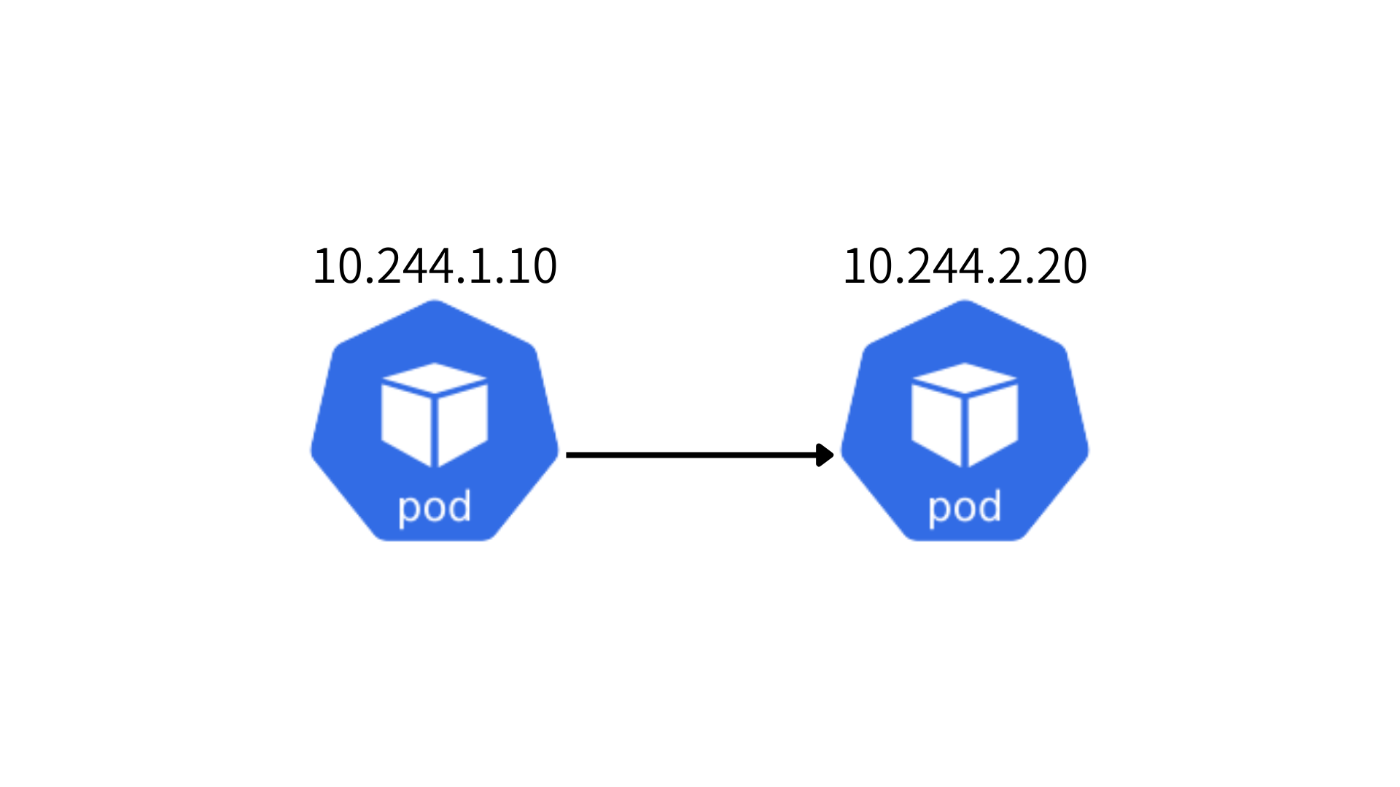
Pod-BのIPアドレスを直接指定すれば良いです。
しかしながら、Podは再作成される短命なリソースです。再作成された場合、その新たなPodには新しいIPアドレスが付与されます。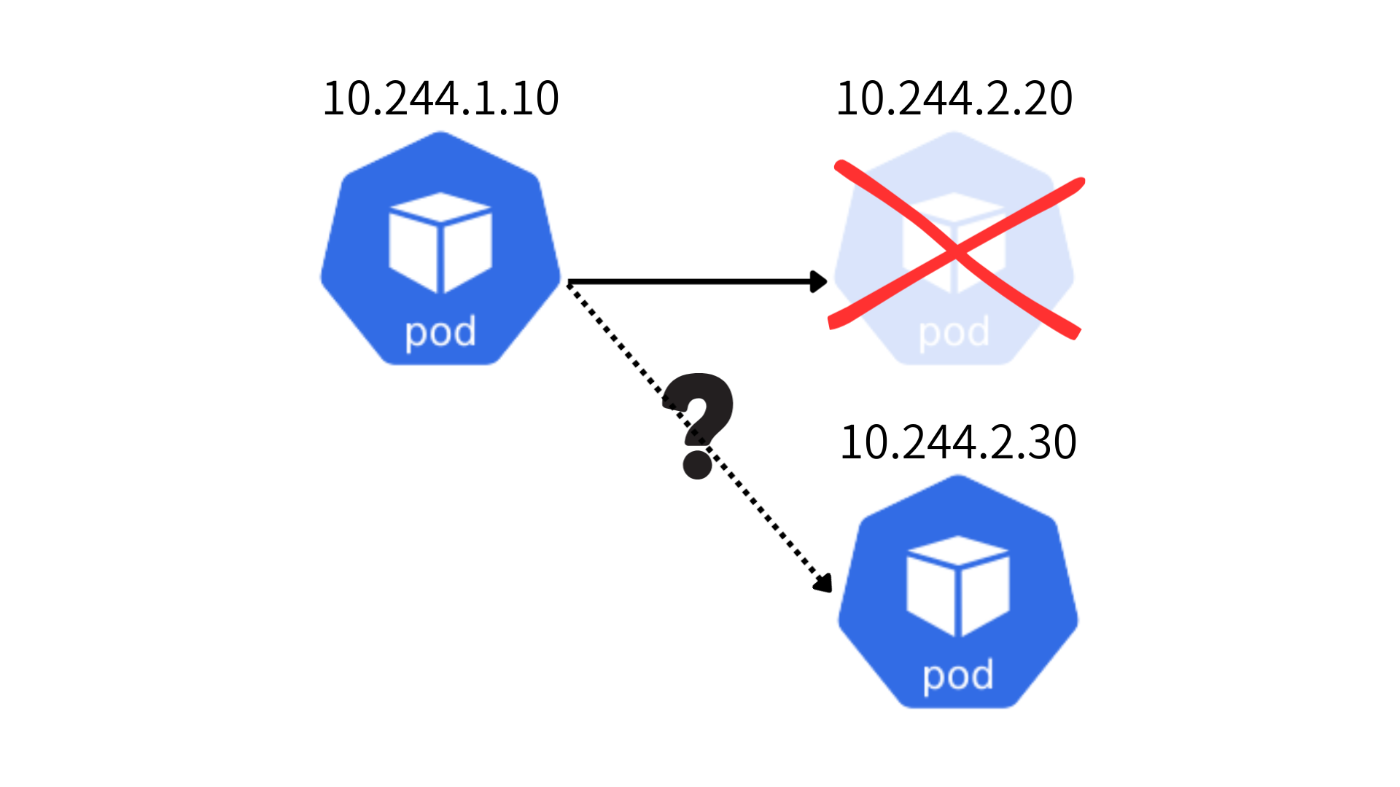
つまり、Podが持つIPアドレスを見て通信していては、再作成されたときに追従できず通信が不可能になってしまいます。
この問題を解決するのがServiceリソースです。 Serviceが提供する機能性として以下2つを取り上げます。
- Pod群に紐づく安定したDNS名を持つ、通信の抽象レイヤー
- クラスタ内外への通信の公開
Pod群に紐づく安定したDNS名を持つ、通信の抽象レイヤー
直接Pod-Bに通信するのではなく、関連づけられたServiceに対して通信するように構成することができます。
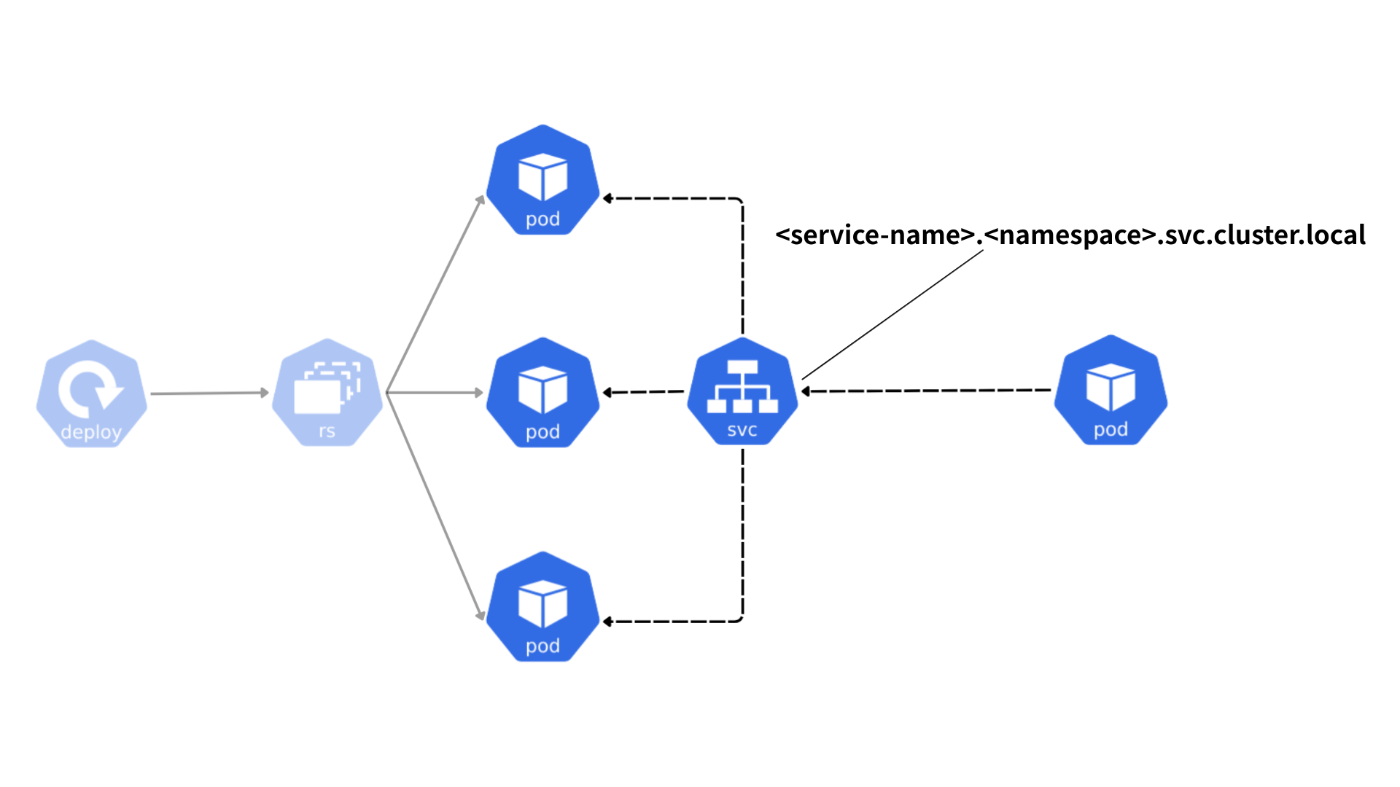
Serviceは、<service-name>.<namespace>.svc.cluster.localという規則でDNS名を持っています。
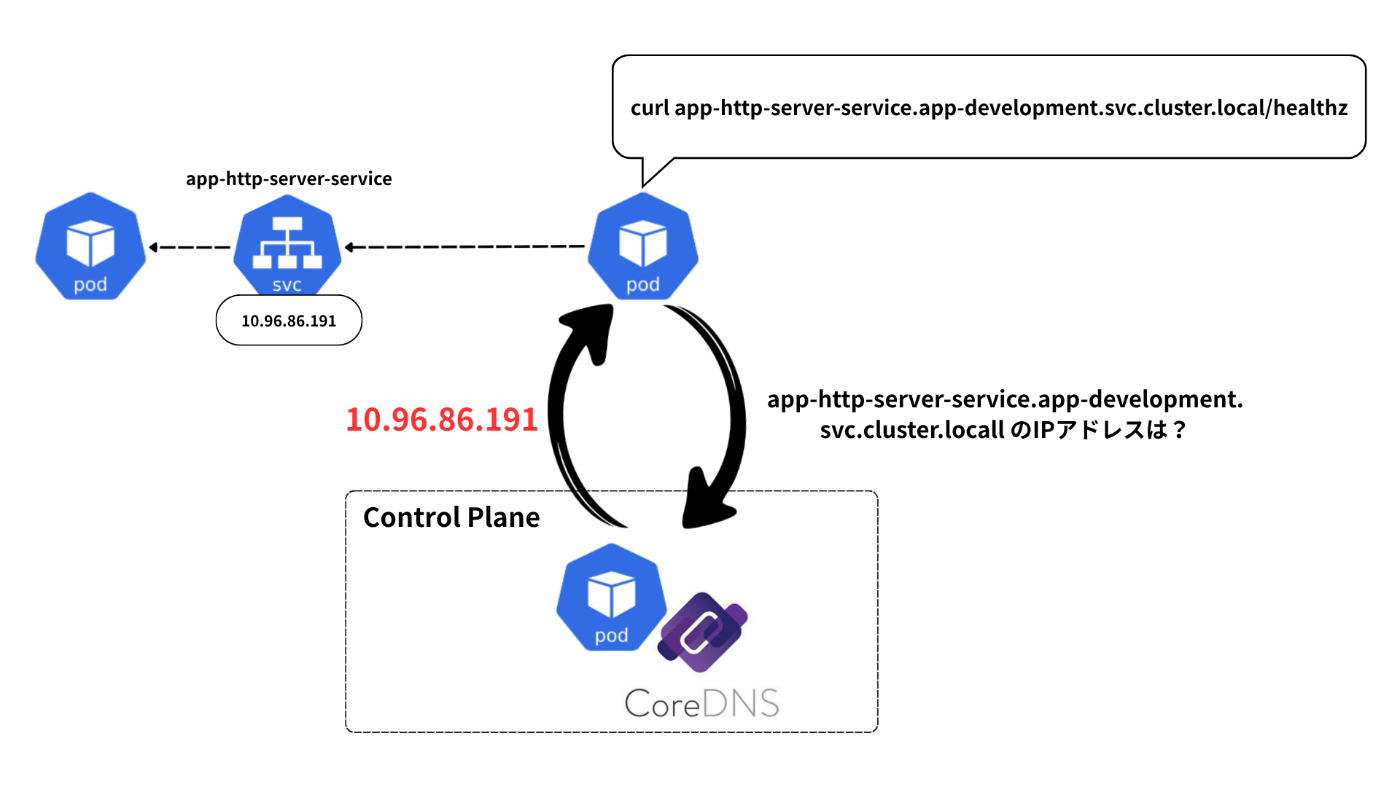
このDNSによる名前解決を可能にしているのは、CoreDNSというadd-onのリソースになります。 ServiceのDNS名に対してClusterIPもしくは PodのIPアドレスを応答します。
EKSでも、デフォルトでこのCoreDNSのPodが起動するようになっています。
もう少し深掘ります。 Serviceには、Endpoints/EndpointSliceというリソースが紐づいています。ここではEndpointSliceリソースを扱います。
Endpointsが元来存在したものです。EndpointSliceは、Endpointsの持っていたパフォーマンス的な課題を解決するために実装された新たなリソースになります。
EndpointSliceリソースには、Serviceとそれに紐づく全てのPodへのIPアドレス:ポートの情報が格納されています。ちなみに、このルーティング情報を格納するのは、EndpointSlice Controller(Control Plane)になります。
リソースの関係性としては、以下のように表せます。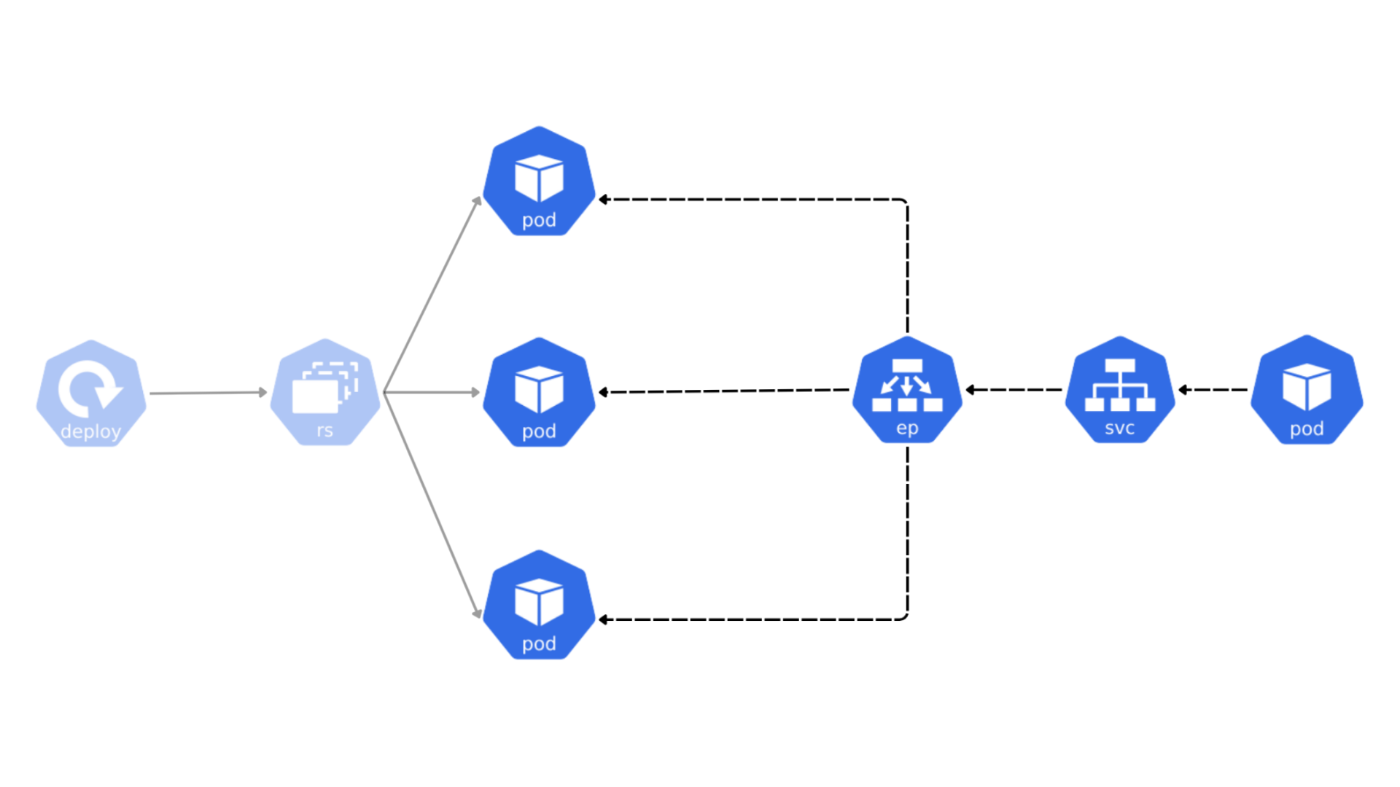
さらには、EndpointSlice自体がルーティングをしているわけではなく、このEndpointSliceの情報を見て、kube-proxyというコンポーネントがネットワーク設定をiptablesコマンドで設定しており、実際のネットワーク処理はLinuxカーネルに任せています。これについては後述します。
クラスタ内外への通信の公開
Serviceにはタイプがあり、それによってクラスタ内へも外へも通信を公開することができます。
クラスタ内への公開:ClusterIP
デフォルトのタイプになります。実はこれはすでに上で扱っていたことで、Serviceという通信の抽象レイヤーを介してPodにアクセス可能になるというものです。
Serviceには、ClusterIPというクラスター内における仮想のIPアドレスが付与されます。そして、CoreDNSによって<service-name>.<namespace>.svc.cluster.localといったDNS名からClusterIPに名前解決されるため、別PodからはDNS名でアクセスできるのでした。
なお、このClusterIPは外部からアクセスしても有効ではありません。
クラスタ外への公開:NodePort, LoadBalancer
NodePortタイプでは、各Worker Nodeに共通のポート(NodePort)を開放し、そのポートへの通信をServiceに転送することで、クラスタ内のPodへの通信を外部に公開します。
PodやServiceなどのリソースは、k8sが管理しているネットワーク空間におけるものです。そのネットワークの窓口的存在としてServiceが立ち、それがWorker Nodeのportと紐づくことで、k8sのネットワークと外部ネットワークが橋渡しされるようになります。
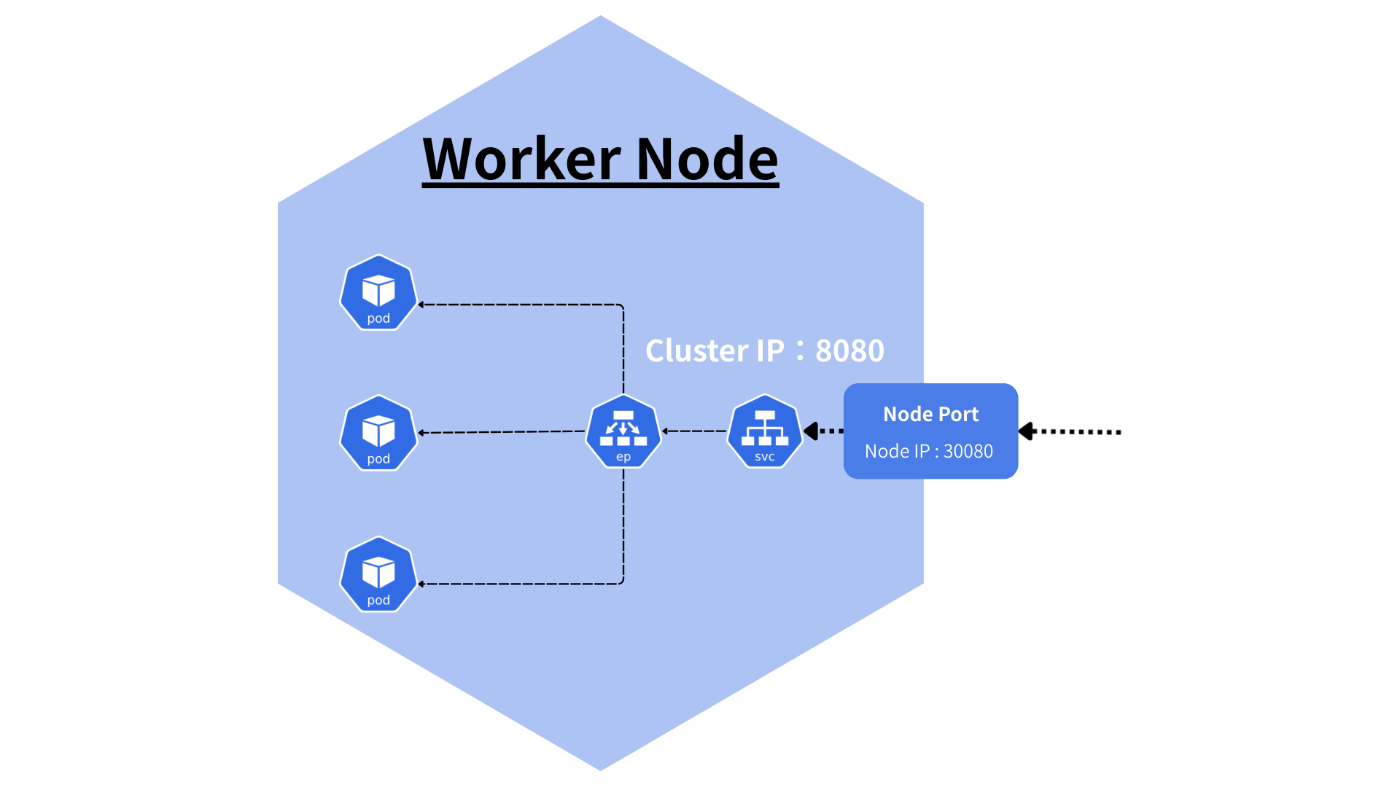
Worker Nodeもクラスタの内部なのに、Worker NodeのPortは外部と通信が可能なのか.....? と疑問に思うかもしれません。これは、Worker Nodeが論理的にはk8sクラスタの一部でありつつ、物理的・ネットワーク的にはクラウドやホストOS上に存在する1台のマシン(VM/コンテナ)だからです。
EKSの場合、EC2のサーバーインスタンスがWorker Nodeとして利用されます。
LoadBalancerタイプだと、クラウドプロバイダのAPIを叩くことでService用にロードバランサーがプロビジョニングされるようになります。K8sリソースによって、AWSリソースであるNLB(Network Load Balancer)の作成が指示されるといった感じです。
実際は、同様にNodePortで通信が公開されており、それをうまくLoadBalancerと紐づけてくれるServiceタイプであると言えそうです。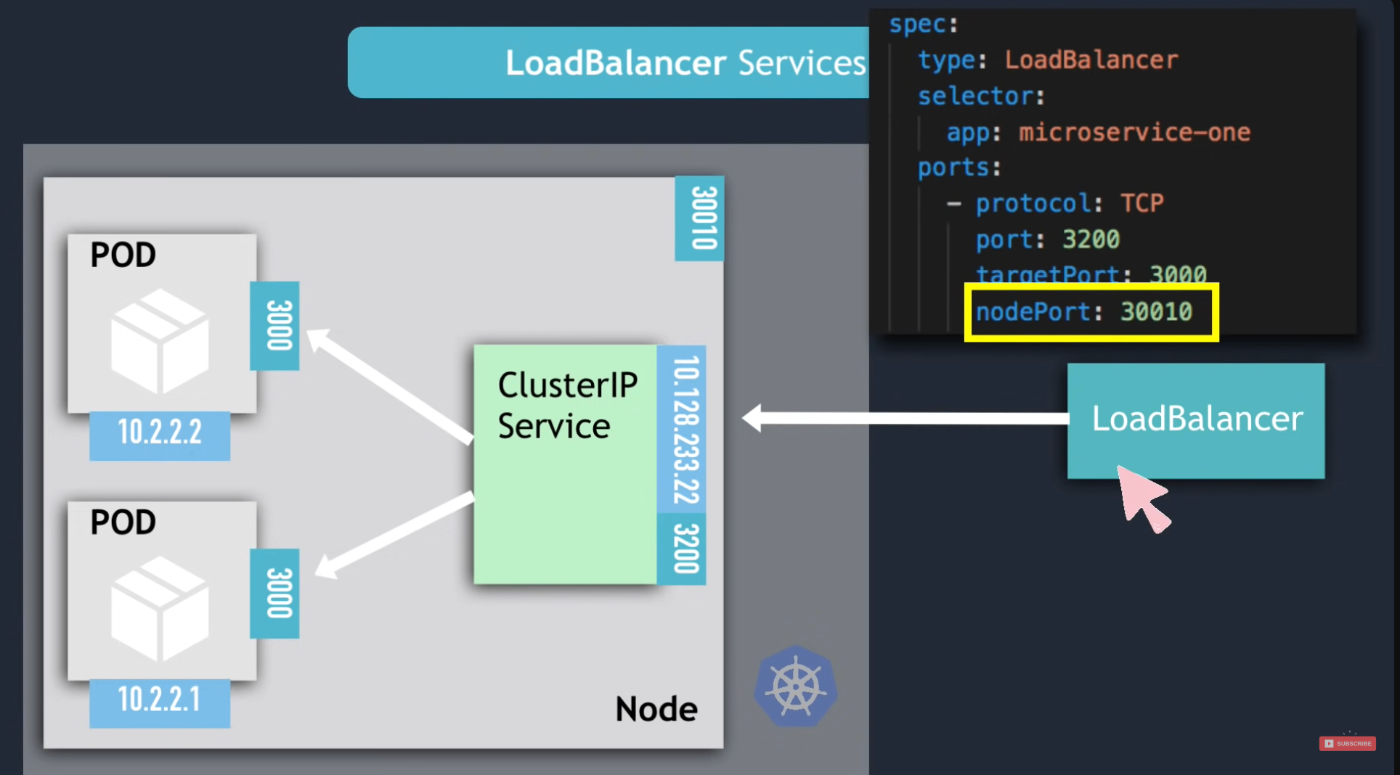 https://youtu.be/T4Z7visMM4E?si=bYFnY6xRJolmE6E0 より抜粋
Service 名を解決するDNS
Service の DNS 名 (<service-name>.<namespace>.svc.cluster.local) でアクセスできる仕組みを、kind 上で実際に覗いて確認してみます。
試しに、適当な一時Podを立てて、そこからapp-http-serverpodにcurlでリクエストしてみましょう。
kubectl run -it --rm curlpod --image=radial/busyboxplus:curl --restart=Never -- sh
shellに入れたら、ヘルスチェック用エンドポイントを叩いてみましょう。
[ root@curlpod:/ ]$ curl -v app-http-server-service.app-development.svc.cluster.local/healthz
以下のように200が返ります。
> GET /healthz HTTP/1.1
> User-Agent: curl/7.35.0
> Host: app-http-server-service.app-development.svc.cluster.local
> Accept: */*
>
< HTTP/1.1 200 OK
< Server: nginx/1.25.5
< Date: Fri, 03 Apr 2026 18:15:46 GMT
< Content-Length: 0
< Connection: keep-alive
ここで、一時的にたてたPodのresolv.confを覗いてみましょう。
resolv.confは、Linuxサーバーにおける名前解決に関する設定が記載されているファイルになります。
OSには「リゾルバ」というプログラムが入っています。このリゾルバはDNSクライアントに相当するものであり、Linux系OSの場合は/etc/resolv.confを参照してDNSサーバーにipアドレスを問い合わせます。
nameserverに注目してみましょう。これは、まさにcoredns serviceのipアドレスを指します。
[ root@curlpod:/ ]$ cat /etc/resolv.conf
# ドメイン名の補完
search default.svc.cluster.local svc.cluster.local cluster.local
# DNSサーバのIPアドレス => corednsのserviceのClusterIP
nameserver 10.96.0.10
# 名前解決の細かい挙動設定 => ドットが5個未満の名前はsearchドメインを補完して解決
options ndots:5
kube-dnsというServiceリソースを覗いてみましょう。10.96.0.10のClusterIPが割り当てられていますね。また、labelにはkubernetes.io/name=CoreDNSとあります。
% kubectl describe svc kube-dns -n kube-system
Name:                     kube-dns
Namespace:                kube-system
Labels:                   k8s-app=kube-dns
                          kubernetes.io/cluster-service=true
                          kubernetes.io/name=CoreDNS
Annotations:              prometheus.io/port: 9153
                          prometheus.io/scrape: true
Selector:                 k8s-app=kube-dns
Type:                     ClusterIP
IP Family Policy:         SingleStack
IP Families:              IPv4
IP:                       10.96.0.10
IPs:                      10.96.0.10
Port:                     dns  53/UDP
TargetPort:               53/UDP
Endpoints:                10.244.0.4:53,10.244.0.2:53
Port:                     dns-tcp  53/TCP
TargetPort:               53/TCP
Endpoints:                10.244.0.4:53,10.244.0.2:53
Port:                     metrics  9153/TCP
TargetPort:               9153/TCP
Endpoints:                10.244.0.4:9153,10.244.0.2:9153
Session Affinity:         None
Internal Traffic Policy:  Cluster
Events:                   <none>
つまり、curl用Pod内でcurl -v app-http-server-service.app-development.svc.cluster.local/healthzを叩いた時、「一度corednsに問い合わせてipアドレスを取得する」という工程が挟まっていたわけですね。
Node上のネットワークルールを設定するkube-proxy
kube-proxyは、ネットワークのルールを設定します。
なおkube-proxyはDaemonSetとして展開されています。 DaemonSetとは、各Node上で1つずつPodが起動することを保証するリソースです。
なので、kubectl get pods -n kube-systemで確認すればkube-proxyのpodが確認できます。
ネットワークルールの設定
kube-proxyはService/EndpointSliceリソースをwatchします。
この2つのリソースの情報を利用し、iptablesルールへの反映をすることによってNodeにおけるネットワークのルーティング設定を行います。 Service宛のリクエストが適切にPodのIPアドレスに変換されるようになるのです。
kube-proxyの動作には3つのモードがあります。
ここでは、デフォルトであるiptablesモードを前提に扱います。
このモードにおいてkube-proxyは、Service/EndpointSliceリソースの情報をもとにiptablesルールを設定するという役割のみを担います。
iptables / netfilter
iptablesは、Linux カーネルのパケット処理ルール(→ netfileter)を設定するためのCLIです。
...となれば、理解すべきはnetfileterですね。
netfilterは、以下の3つの概念で構成されます。
- table:
- 目的別にパケット処理を分類する論理的な単位
- 「このパケットに何をしたいか」という処理の目的を表す
- 例:
filter(許可)nat(アドレス/ポート変換)mangle(パケット改変)raw(conntrack制御)
- chain:
- パケットが通過する処理ポイント(フック)
- パケットのライフサイクル上の「どの処理段階で処理するか」を表す
- 例:
PREROUTING(ルーティング判定前)INPUT(ローカルプロセス宛てのパケット)FORWARD(他ホストへ転送されるパケット)OUTPUT(ローカルプロセスから送信されるパケット)POSTROUTING(ルーティング判定後)
- rule:
- 条件とアクションの組み合わせ
- chainの中に順序付きで並ぶ
- アクション例:
DNAT(宛先アドレス変換)SNAT(送信元アドレス変換)ACCEPT(パケットを通す)DROP(パケットを落とす)JUMP(chainを跨ぐ)
kube-proxyが操作するほとんどがnatテーブルになります。(次いでfilter, mangleテーブルになりそうです) ここではnatテーブルについて取り上げます。
以下のように設定されているものとイメージしましょう。
nat table
| hook | chain | rule(役割) |
|---|---|---|
| PREROUTING | PREROUTING | 宛先IP/Port条件で 別chainへJUMP |
| PREROUTING | DNAT-CHAIN | DNAT(宛先IP/Port書き換え) |
| 例:203.0.113.10:80 ⇨ 192.168.1.100:8080 | ||
| OUTPUT | OUTPUT | 自プロセス発の通信を 別chainへJUMP |
| OUTPUT | DNAT-CHAIN | DNAT(loopback含む) |
| POSTROUTING | POSTROUTING | 送信元IP条件で SNAT / MASQUERADE |
| 例:192.168.1.100:8080 ⇨ 203.0.113.10:80 |
203.0.113.10:80宛のパケットが送られてきた場合は以下のように以下のように宛先/送信元のアドレスが変換されるなどします。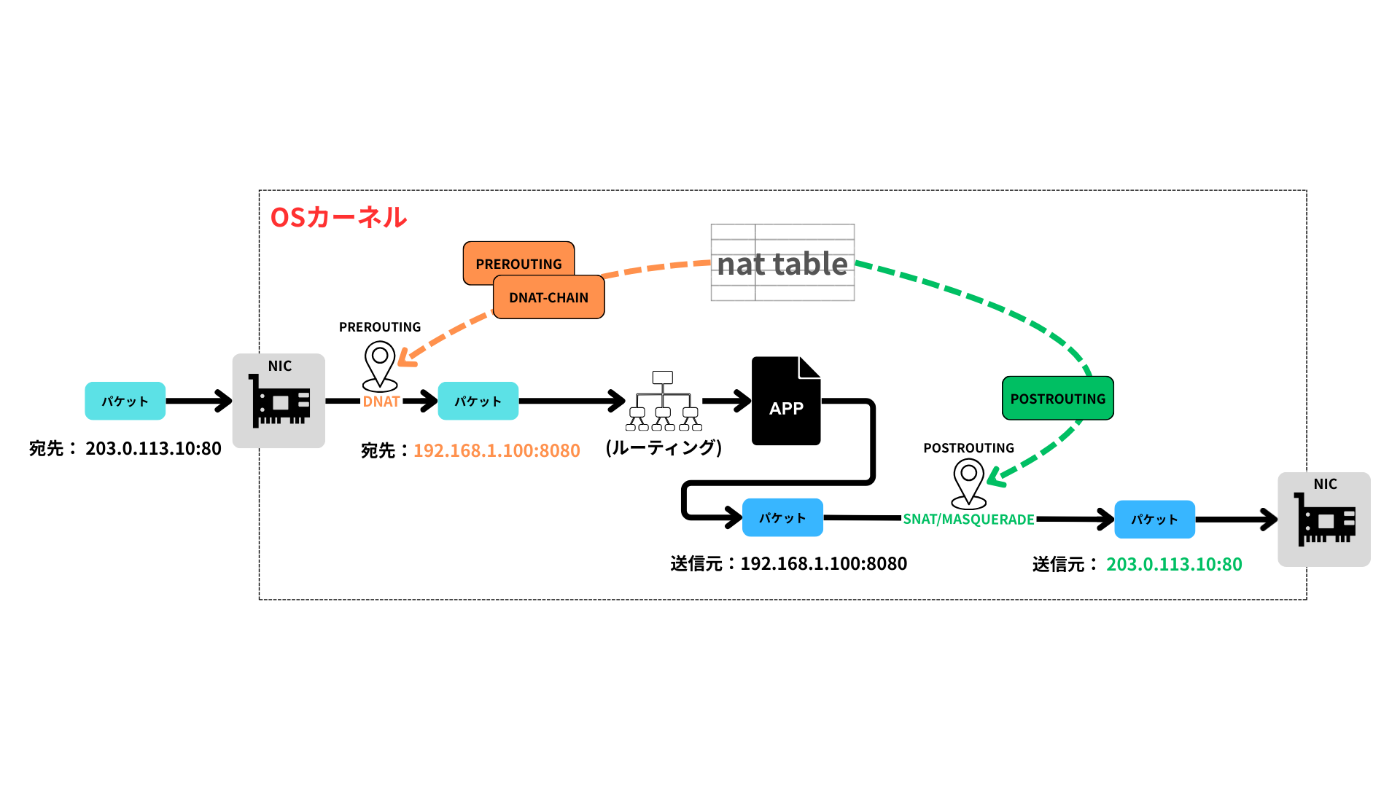
netfilterを通して、フック(パケットの処理段階)ごとに対応するchainのruleが動作するイメージです。ちなみに、上の表だとDNAT-CHAINは任意に設定したchain名になります。
また、ルーティング処理はカーネル内の別システムが担いますがここでは割愛します。Linuxカーネルがうまくやってくれるとだけ把握しておきましょう。
kube-proxyが設定するnat table
PodがReplicaset=3で起動している & NodePort(30080番) Serviceで公開している場合、kube-proxyは以下のようにnat tableを設定します(一部略)。
nat table
| hook | chain | rule |
|---|---|---|
| PREROUTING | PREROUTING | 全パケットを KUBE-SERVICES へ JUMP |
| PREROUTING | KUBE-SERVICES | 宛先が Service 関連(ClusterIP / NodeIP 等)なら Service 判定へ・ClusterIP → KUBE-SVC-xxxx・LOCAL(NodeIP) → KUBE-NODEPORTS |
| PREROUTING | KUBE-NODEPORTS | dst-port=30080(NodePort) → KUBE-EXT-yyyy |
| PREROUTING | KUBE-EXT-yyyy | 外部通信として MARK(SNAT が必要な場合)KUBE-MARK-MASQ Service chain へ JUMPKUBE-SVC-yyyy |
| PREROUTING | KUBE-SVC-yyyy | 確率ベースで Endpoint chain を選択 |
| PREROUTING | KUBE-SEP-aaaa | DNAT → PodIP:8010.244.1.2:80 |
| PREROUTING | KUBE-SEP-bbbb | DNAT → PodIP:8010.244.1.3:80 |
| PREROUTING | KUBE-SEP-cccc | DNAT → PodIP:8010.244.1.4:80 |
| POSTROUTING | KUBE-POSTROUTING | MARK された通信を MASQUERADE(SNAT) |
iptablesコマンドのutilsパッケージが用意されているのが以下からわかります。このパッケージは、主にkube-proxyが利用します。
// kubernetes/pkg/util/iptables/iptables.go
//go:build linux
package iptables

// 省略
func (runner *runner) runContext(ctx context.Context, op operation, args []string) ([]byte, error) {
	iptablesCmd := iptablesCommand(runner.protocol)
	fullArgs := append(runner.waitFlag, string(op))
	fullArgs = append(fullArgs, args...)
	klog.V(5).InfoS("Running", "command", iptablesCmd, "arguments", fullArgs)
	if ctx == nil {
		return runner.exec.Command(iptablesCmd, fullArgs...).CombinedOutput()
	}
    // os/execパッケージを用いてiptablesコマンド実行
	return runner.exec.CommandContext(ctx, iptablesCmd, fullArgs...).CombinedOutput()
	// Don't log err here - callers might not think it is an error.
}
kube-proxyの構造体のフィールド情報から、iptablesパッケージのインターフェースに依存していることがわかります。
// kubernetes/pkg/proxy/iptables/proxier.go
// Proxier is an iptables-based proxy
type Proxier struct {
    // 省略
    // utiliptablesはiptablesパッケージのalias
    iptables       utiliptables.Interface
}
iptablesはユーザー空間で利用するツールであるため、システムコールとかではなく、外部コマンド呼び出しになっている感じなんですね。
そして、NodeIP:30080でリクエストが来た場合、PREROUTINGフックを起点にchainを乗り継ぎ、以下のようにnetfilterが動作してPodへのIPが決まります。
最終的にはKUBE-SEP-ccccchainがDNATを行い、Pod IPへと変換している様子を表しています。
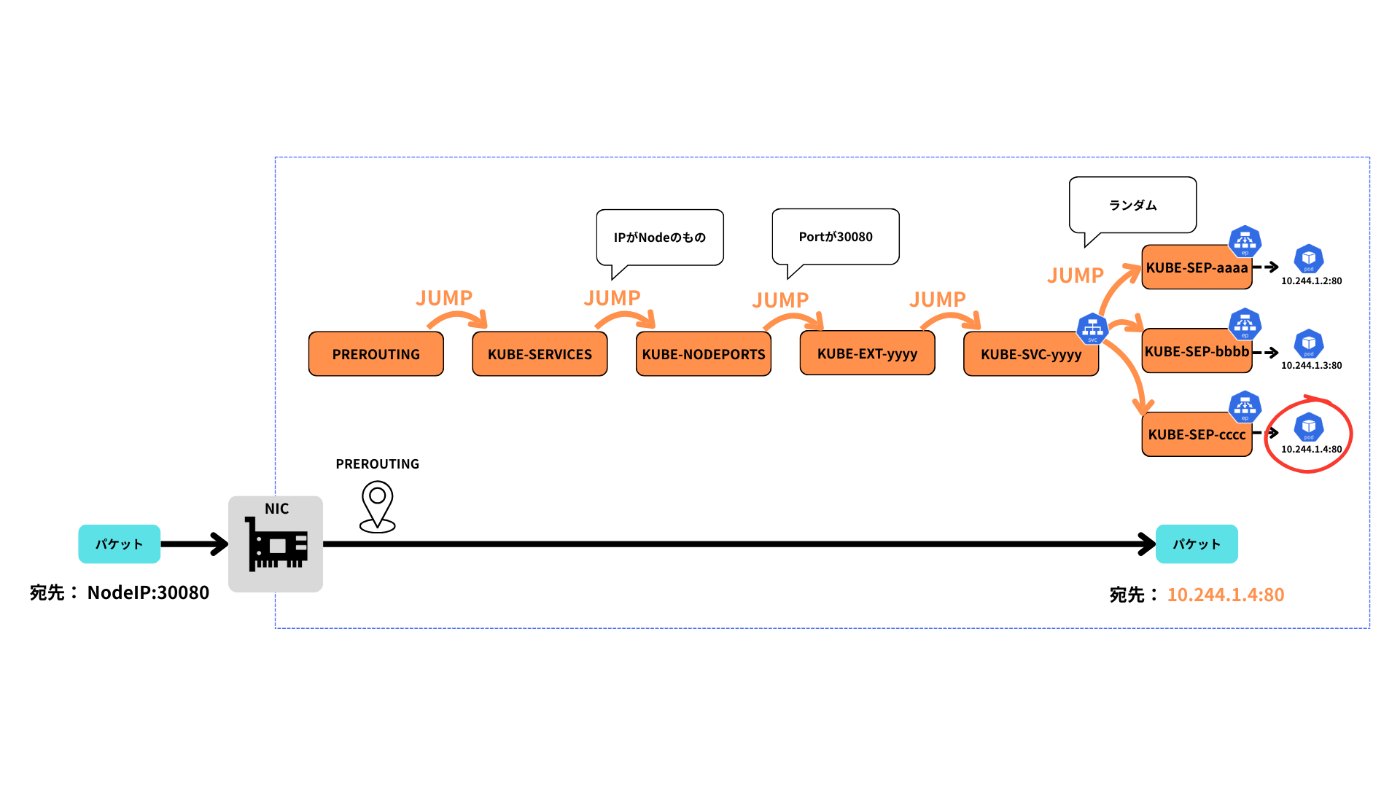
おさらいですが、EndpointSliceリソースが各PodへのIPアドレスを持っていて、EndpointSliceを束ねている上位レイヤーがServiceでした。iptablesでも同じように設定されていたんですね。
以下にまとめます。
- kube-proxyがService/EndpointSliceリソースをもとにiptablesを使い、Node上にネットワークルールを構築している
- Linuxカーネルがこれらのルールを適用することで、Service宛のリクエストがPodのIPアドレスに変換される
Pod ネットワークを実現するCNIプラグイン
ここまでは「Service への通信が Pod に届くまで」を見てきましたが、そもそも Pod が独立した IP を持って通信できているのは何のおかげか、というところを次に見ていきます。
kindnet pod自体は、名前から察せられるようにKind Cluster特有のものになります。
kindnetはCNI(Container Network Interface)プラグインの一種です。
CNIとは、Podやコンテナのネットワークを管理・接続するための標準仕様(インターフェース)です。
k8sのネットワークといえば、先ほどkube-proxyについて取り上げました。
- kube-proxyがService/EndpointSliceリソースをもとにiptablesを使い、Node上にネットワークルールを構築している
- Linuxカーネルがこれらのルールを適用することで、Service宛のリクエストがPodのIPアドレスに変換される
対して、CNIプラグインはPodネットワークの構築の役割を果たしているといえます。
「Podネットワークの構築」の意味するところについて、少しだけ解像度を上げていきましょう。
CNIの文脈において、container = network namespace(netns) になります。
netnsはLinuxのネットワーク機能です。 1台のマシン上に仮想ホストを作成でき、その仮想ホストにはIPアドレスやNICを持たせることもできます。
インターフェースとしては以下の二つが主に定められています。
- ADD :
  - netnsにinterfaceを作成(→別netnsと通信する口を作る)
  - netnsにipアドレスを割り当て
  - ルーティング設定
- DEL :
 - interfaceを削除(→通信の口を閉じる)
  - IPアドレスを解放
  - ルーティングを削除
ここで理解しておきたいのは、Pod単位でnetnsが作られており、コンテナはそのnetnsを共有していることです。 http-server podのnetnsをコンテナが共有していることを以下で確認します。
# Podのnetns idを確認
% kubectl exec  app-http-server-5449665dbb-7mkjc -n app-development -- readlink /proc/1/ns/net
Defaulted container "http-server" out of: http-server, nginx
net:[4026534098]

# http-serverコンテナのnetns idを確認
% kubectl exec  app-http-server-5449665dbb-7mkjc -c http-server -n app-development -- readlink /proc/1/ns/net
net:[4026534098]

# nginx(サイドカー)コンテナのnetns idを確認
% kubectl exec  app-http-server-5449665dbb-7mkjc -c nginx -n app-development -- readlink /proc/1/ns/net
net:[4026534098]
CNIプラグインはnetns(≒ Pod)にIPアドレスを付与し、netns外との通信ができるように仮想NIC(Network Interface Card)であるveth(Virtual Ethernet Device)を配置します。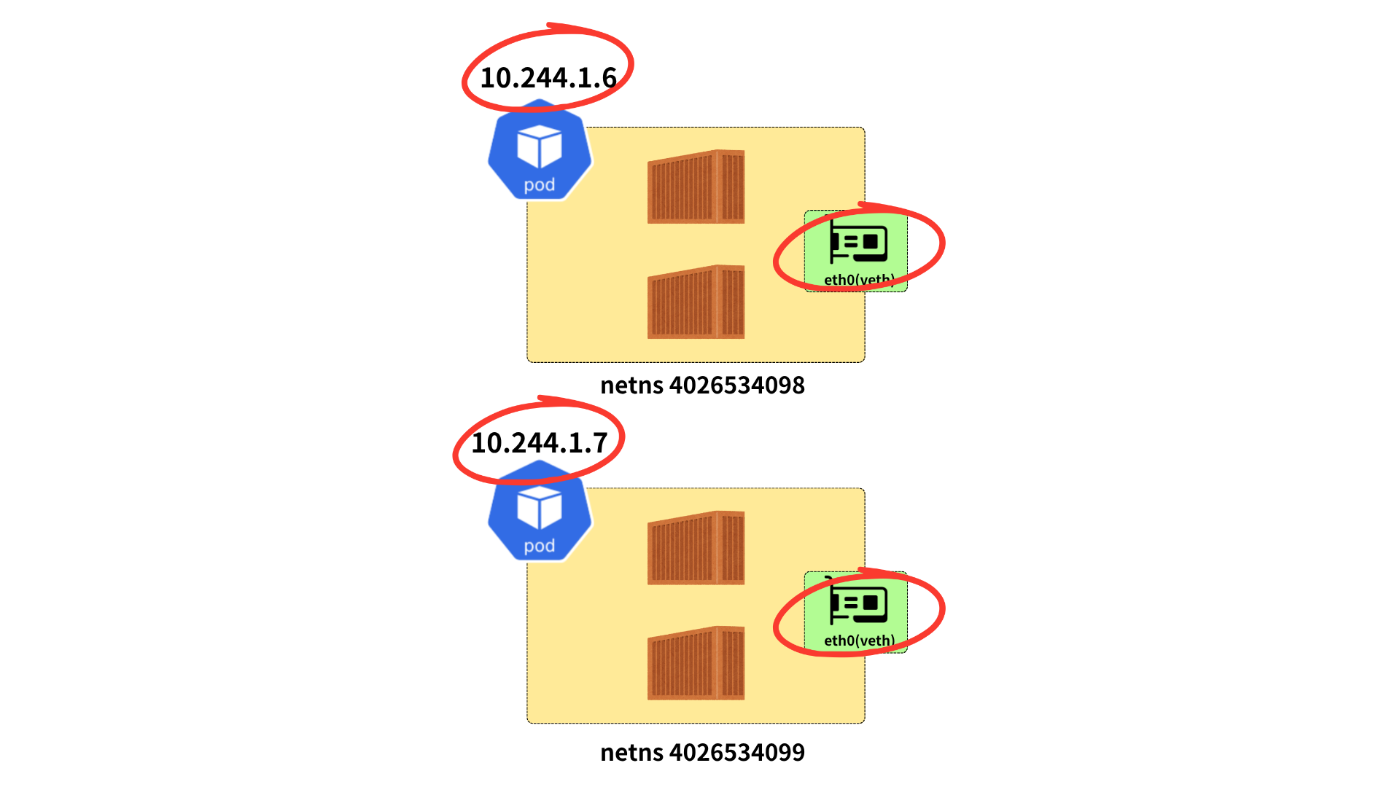
これではまだPod同士は独立したネットワークです。では、どうやってPod同士、ひいてはWorker Node(ホストマシン)外と通信できているのでしょうか。
ここからはLinuxのお話にもなってきますが、vethはペアで成り立ちます。
以下のように、vethがペアで接続されることで、Podの独立したnetnsがホスト(root netns)と通信可能になります。これにより、PodネットワークがWorker Nodeのルーティングに組み込まれます。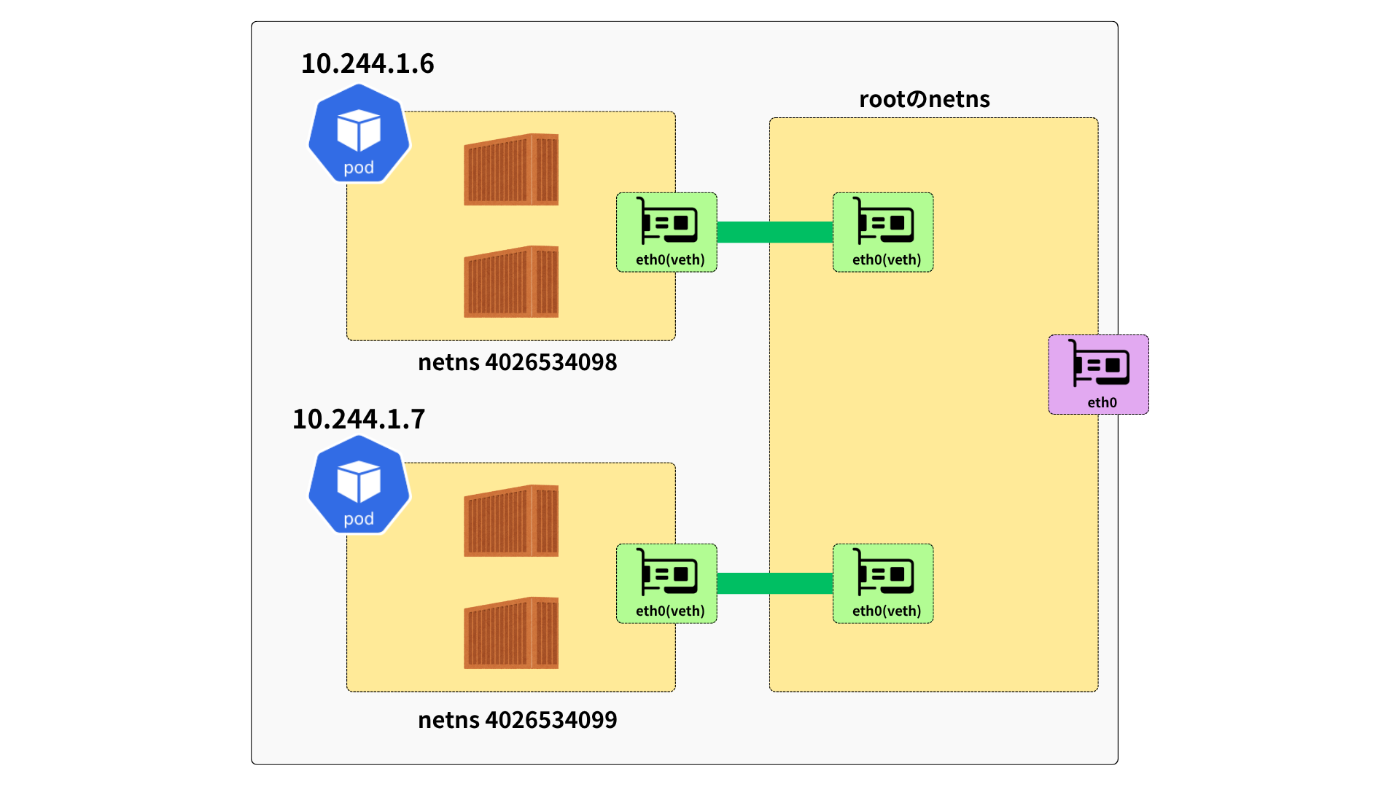
CNIはインターフェースであり、実装方法は様々です。
例えば、Kindの場合、Worker NodeはDockerコンテナです。 Worker Nodeコンテナのeth0も実際はvethであり、ホストマシンのvethと接続されます。そのvethがブリッジ(L2スイッチ)に接続され、ネットワークを実現しているようです。参考:https://note.com/minato_kame/n/n81b1a4396807
まとめると、
- CNIプラグインがPodという1つのnetnsにIPアドレスを割り当て、vethでWorker Nodeのroot netnsと接続し、ルーティングに組み込むことで、「Pod間ネットワークの構築」が実現されている
といえそうです。
まとめ
ここまで見てきた Kubernetes のネットワークを、Worker Node 上で何が起きているかという観点で整理すると次のようになります。
- kube-proxy が Service / EndpointSlice リソースをもとに iptables を使い、Node 上にネットワークルールを構築している
- Linux カーネルがこれらのルールを適用することで、Service 宛のリクエストが Pod の IP アドレスに変換される
- CNI プラグインが Pod の IP アドレスを管理し、Pod 間および Pod と外部のネットワークを接続することで、通信が実現される
「Service の DNS 名で別 Pod を呼べる」「ブラウザから NodePort 経由で Pod にリクエストが届く」という挙動は、この 3 つの役割の組み合わせで成り立っているわけですね。
そして、実際のネットワーク機能自体はLinuxによって実現されているものであり、kubernetesはうまい具合にそれを利用していたということもわかりました。
これらのことを知った上で、以下の言葉を聞くと、確かにそうだな....と納得できます。
Kubernetes is just Linux
Linuxカーネルのことについては、本稿で記載した程度のことしか理解できていないので、もっと深ぼってみたい気持ちになりました。
おわりに
本記事は、Zenn 本「理解して構築してデプロイするまでやるインフラハンズオン」の 3 章「helmfile で k8s manifest を管理する」と 4 章「kind クラスターでデプロイしてみる」から、Kubernetes ネットワークまわりの踏み込んだ部分を抜き出して、1記事として整理しなおしたものです。
本書では、Docker でアプリをコンテナ化するところから、Helmfile で Kubernetes マニフェストを書き、Terraform で EKS 環境を構築し、最終的に EKS にデプロイするところまでを、一連の流れで手を動かしながら追えるようにしています。本記事のような「内部実装まで踏み込む」話を、ハンズオンの流れの中で挟みながら進めていく構成です。
興味がある方は是非。