はじめに
Kubernetes(以降、k8s)という、コンテナ化されたアプリケーションを自動で配置・実行・管理するためのオーケストレーションプラットフォームがあります。
k8sではアプリケーションの状態や構成を manifest(マニフェスト) と呼ばれる YAML ファイルで定義します。このハンズオンでは、そのmanifestを効率的に整理・管理するためにhelmfileというツールを用います。
この章では、k8sの仕組みにも触れていきます。
構成図で言うと、以下の部分です(ここは微妙に表しにくいんですが、まあ大体で)。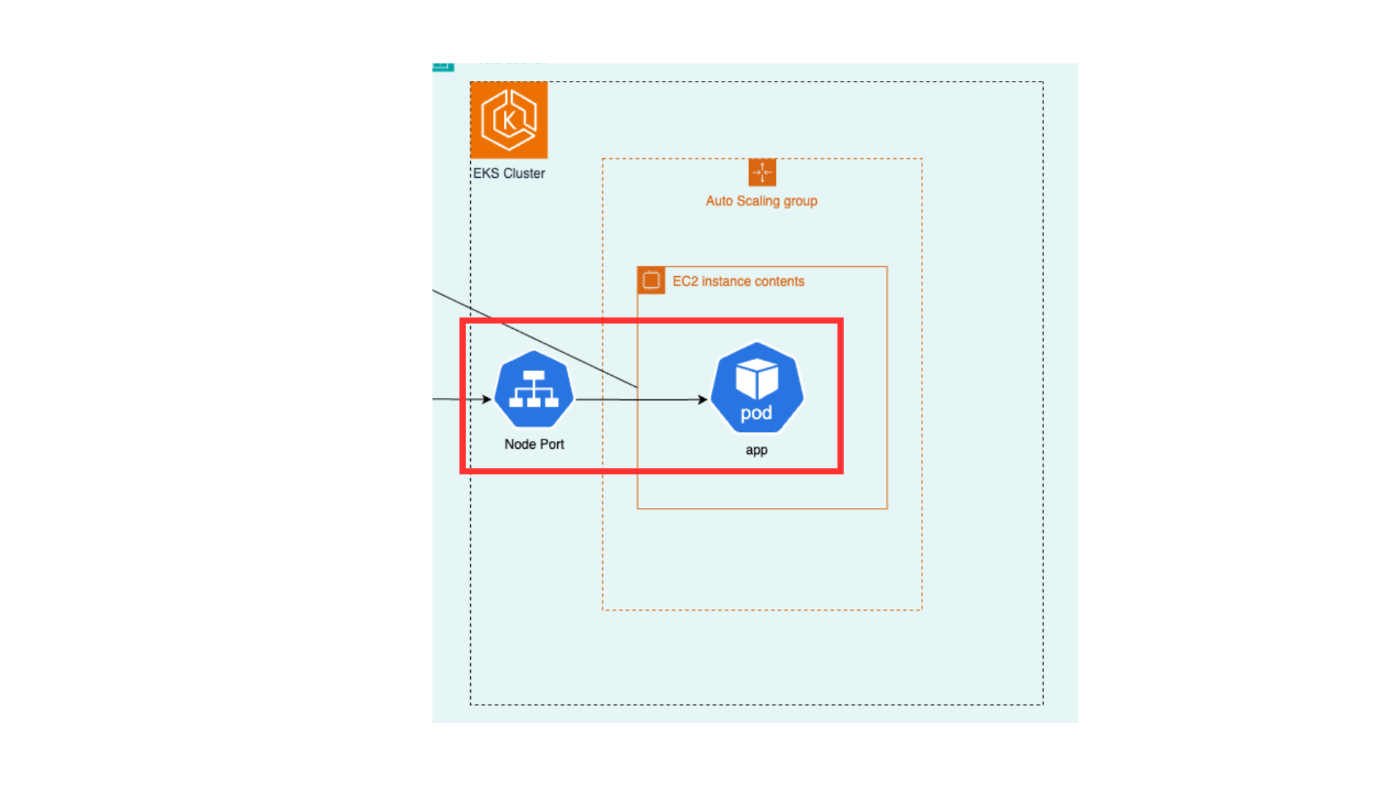
k8sは何を実現するのか
k8sという技術は、具体的には何を実現してくれるのでしょうか。この辺は、説明している記事も書籍も多いと思ったので参考記事を示す程度にとどめます。
k8sは、宣言的に定義した「リソースのあるべき状態」に従って、コンテナを自動的に配置・管理するオーケストレーターな訳ですね。
以下のように(雑)いい感じにスケールアウトさせたり、新旧Podをいい感じに入れ替えながらダウンタイムを抑えてデプロイということもできます。
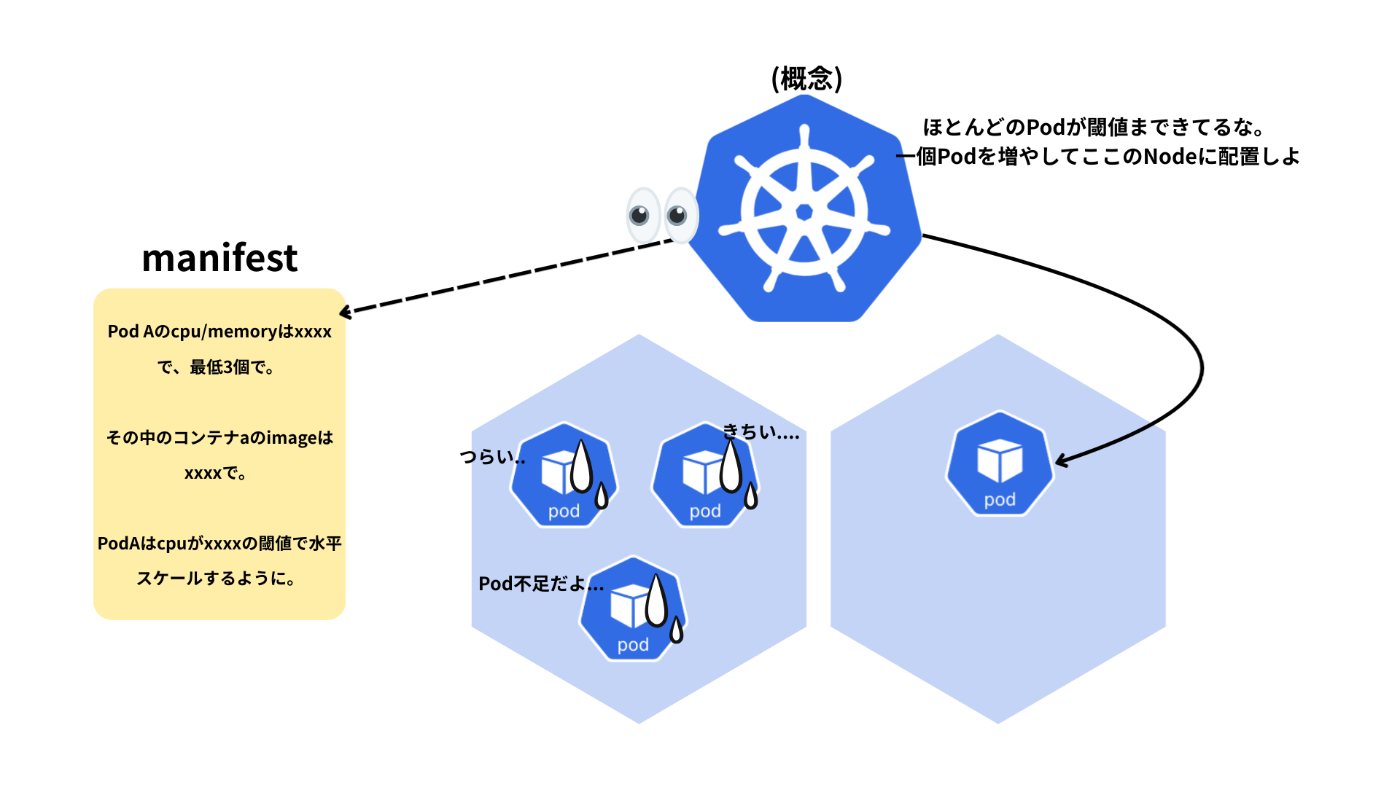
YAMLフォーマットで宣言的に記述する設計図のようなものを、mainfestと呼びます。
k8sコンポーネントをイメージで捉える
上で示した図では、かなり雑にk8sを概念的に表していましたが、k8sのアーキテクチャをここで抑えておきます。ここを抑えておくことで、5章で扱うAWSリソースとの関係性もクリアに理解することができます。それゆえ、筆者的に大事な部分だと思うので、しっかり扱うことにします。
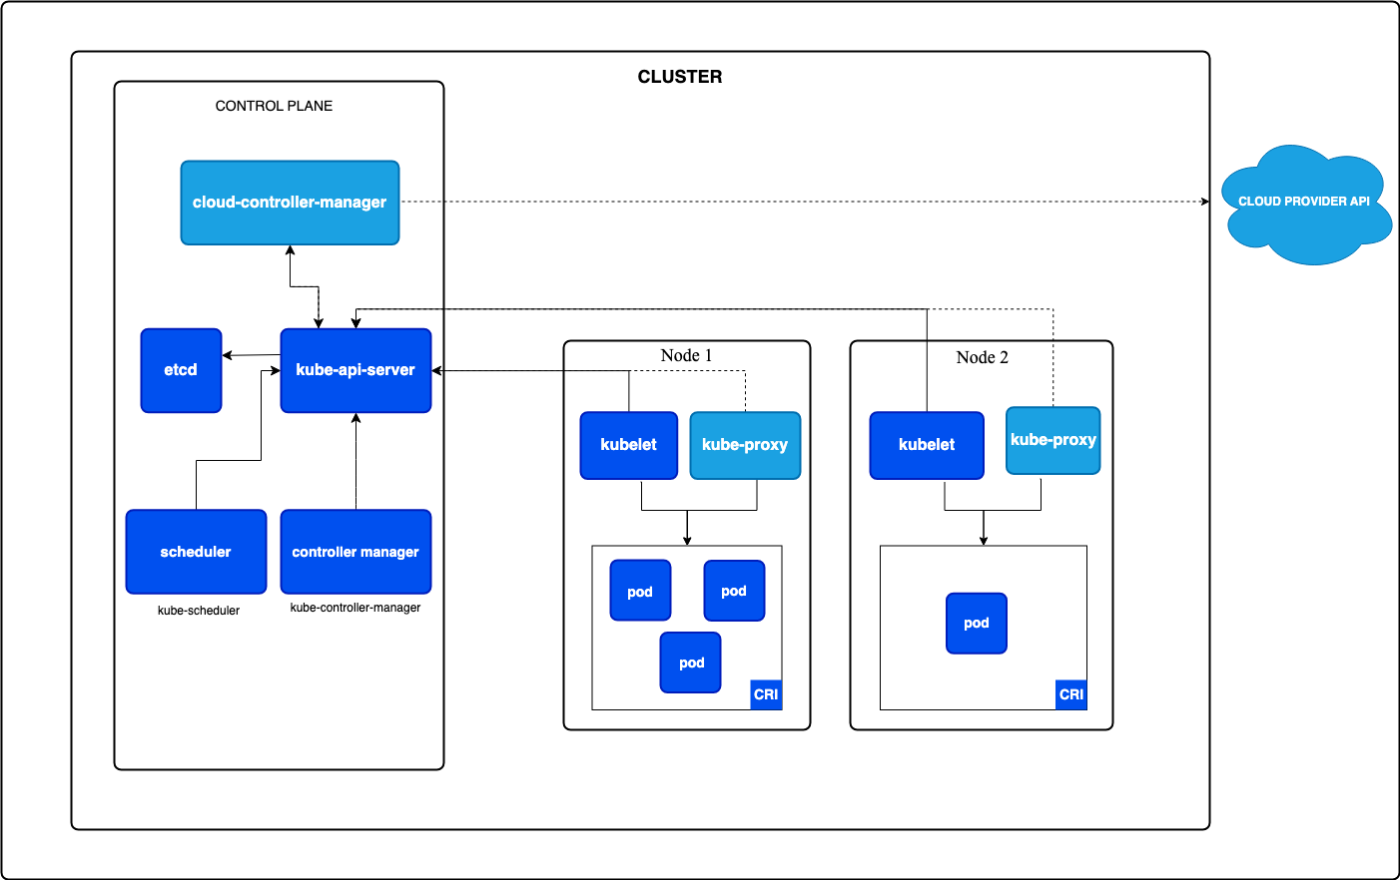 https://kubernetes.io/ja/docs/concepts/architecture/
まず、kubernetes クラスターという大きな塊があります。これは、簡単に言えばk8sの世界そのものだと考えるといいと思います。
Kubernetes (k8s) クラスタは、コンテナ化されたアプリケーションを実行するノードの集合体です。
引用:https://www.redhat.com/ja/topics/containers/what-is-a-kubernetes-cluster
そして、クラスタを構成するのは、大きく2つの種類のノードに分かれます。
- Worker Node
- Podが実際に動作する実行環境
- Controle Plane(Master Node)
- クラスター全体の状態を管理する
クラスター内に存在するControl Planeは1つですが、Worker Nodeは複数個の配置が可能です。それでは、それぞれのノードに含まれるコンポーネントをそれぞれ見ていきます。
が、その前に、重要なリソースについて理解することから始めましょう。 "Pod", "Service"の大きく分けて二つを取り上げます。
Pod
Podとは、コンテナの集合体です。
1つのPodには、協調して稼働させる必要があるコンテナを1ユニットとして稼働させることができます。そのように、メインとなるアプリケーションコンテナに付随して起動させるコンテナを、サイドカーコンテナといいます。
今回は、以下のようにnginxをサイドカーコンテナとして用意し、リバースプロキシとして一緒に稼働させます。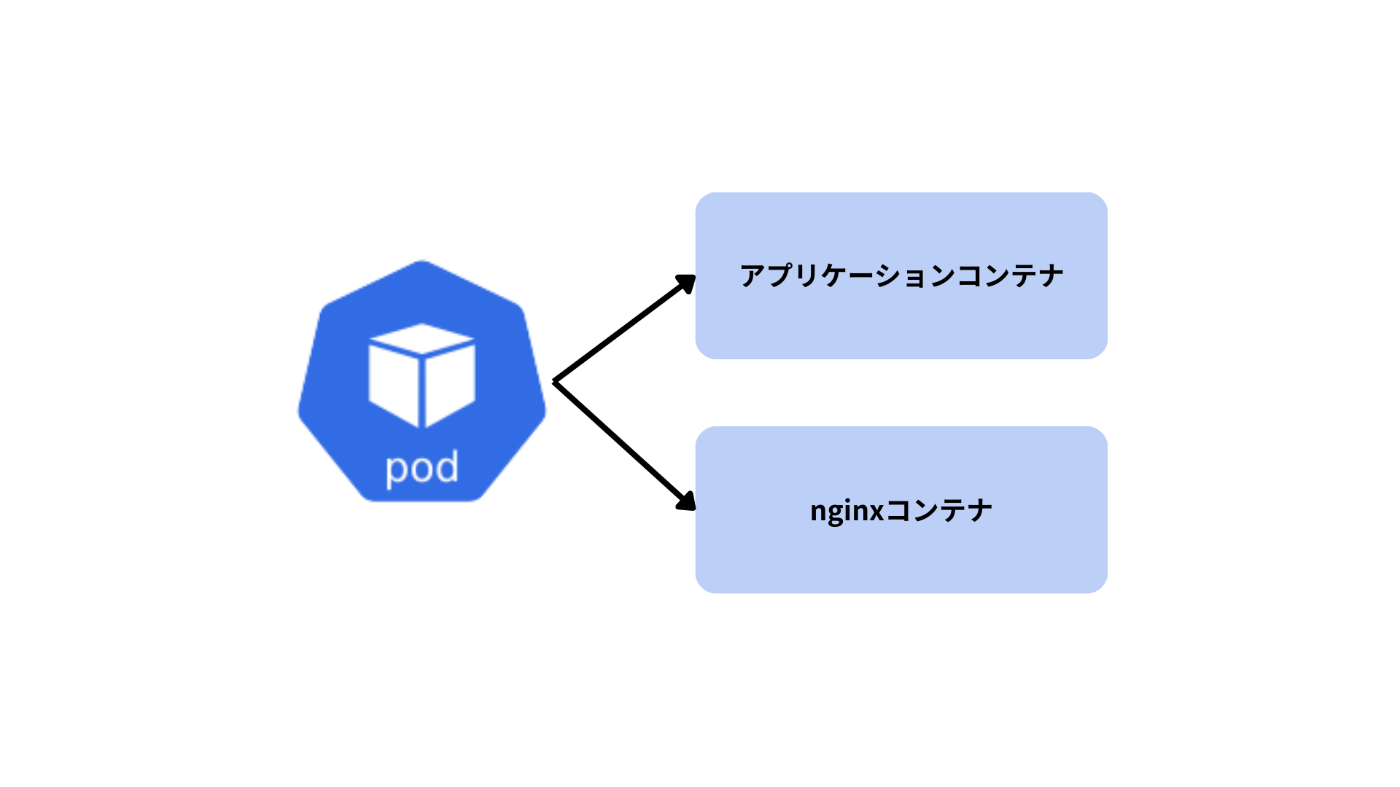
他にも、ログ収集用にfluentd等をサイドカーコンテナとしておくことも多いようです。
また、Pod内にはvolume, IPアドレスも含まれます。
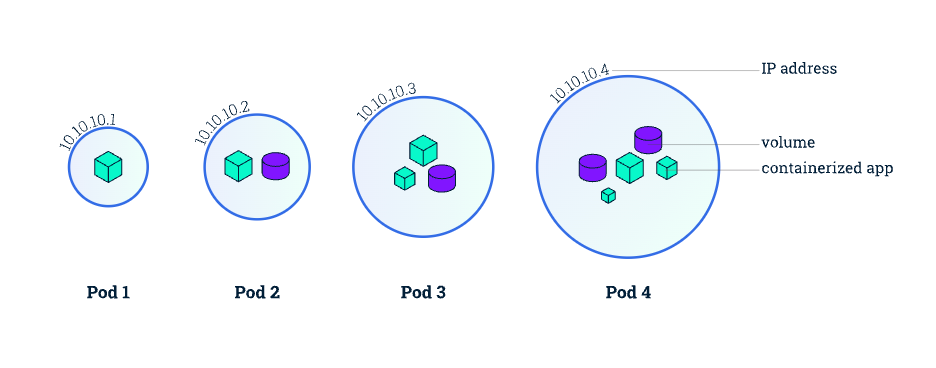 https://kubernetes.io/ja/docs/tutorials/kubernetes-basics/explore/explore-intro/
ReplicaSet
ReplicaSetは、指定されたレプリカ数でPodを稼働し続けることを保証します。 Podを複製し、それを束ねて管理するリソースと捉えることができます。
これにより、Podを冗長化させることができます。たとえば、3つのレプリカ数でPodが稼働していた場合、1つが落ちても他の2つは稼働しているため、サービスを継続して提供することができます。また、Serviceリソース(後述)と組み合わせることで、リクエストが複数のPodへ分散されます。
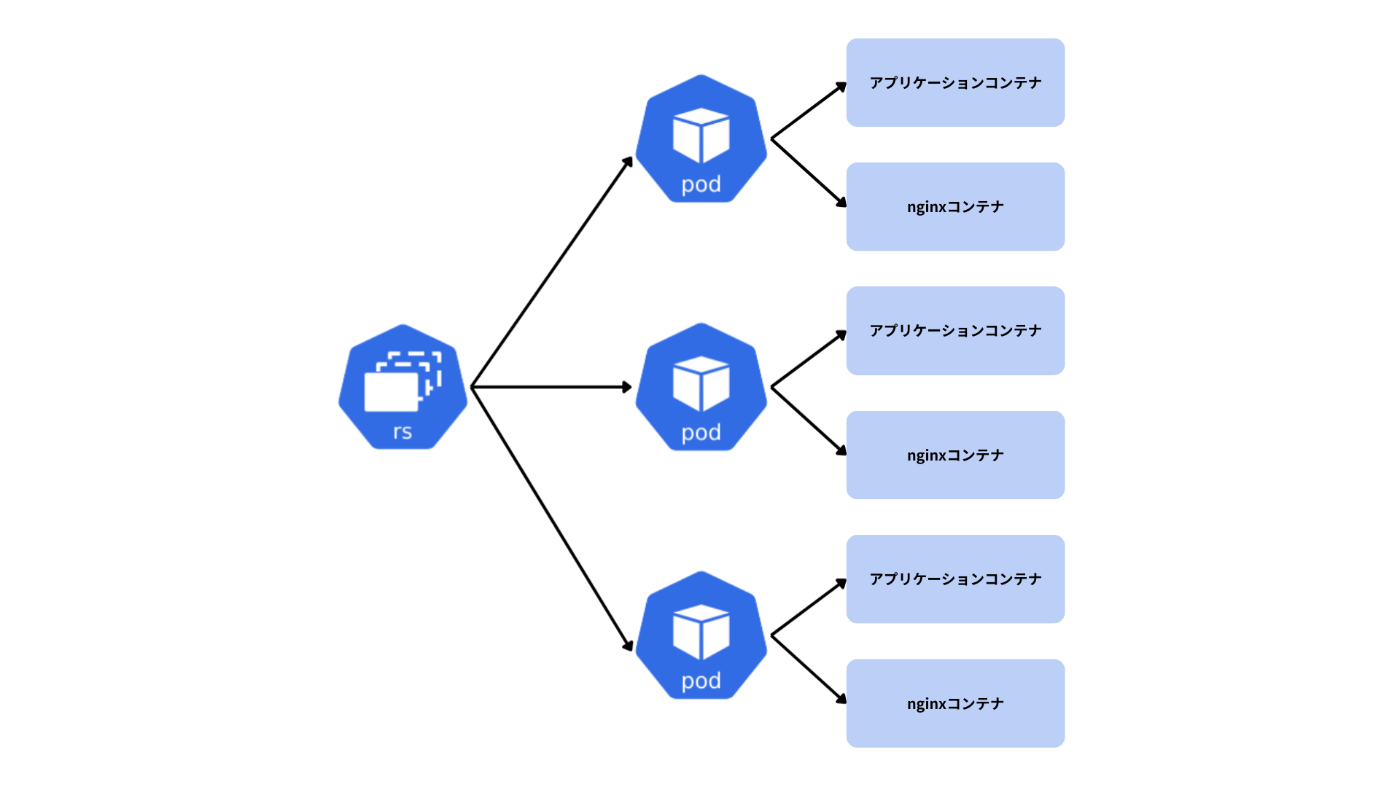
まとめると、Podが冗長化することによって、可用性+負荷分散の点でメリットが大きいんですね。
Deployment
Deploymentは、Replicasetを管理する、最上位のデプロイ単位と言えます。つまり、「Deployment→Replicaset→Pod→コンテナ」という関係性になります。
Pod単体で扱うことも、Replicasetを直接扱うこともほとんどなく、基本的にはDeploymentを利用します。
k8sは、新旧Podの入れ替え(=デプロイ)を、ダウンタイムを最小限に行えると述べましたが、これはDeploymentが内部でReplicaSetを管理し、ローリングアップデート戦略を用いるからです。
ローリングアップデート
アプリケーションの可用性に影響を与えないよう、一気に新旧Podを総入れ替えするのではなく、段階的なアップデートを行います。
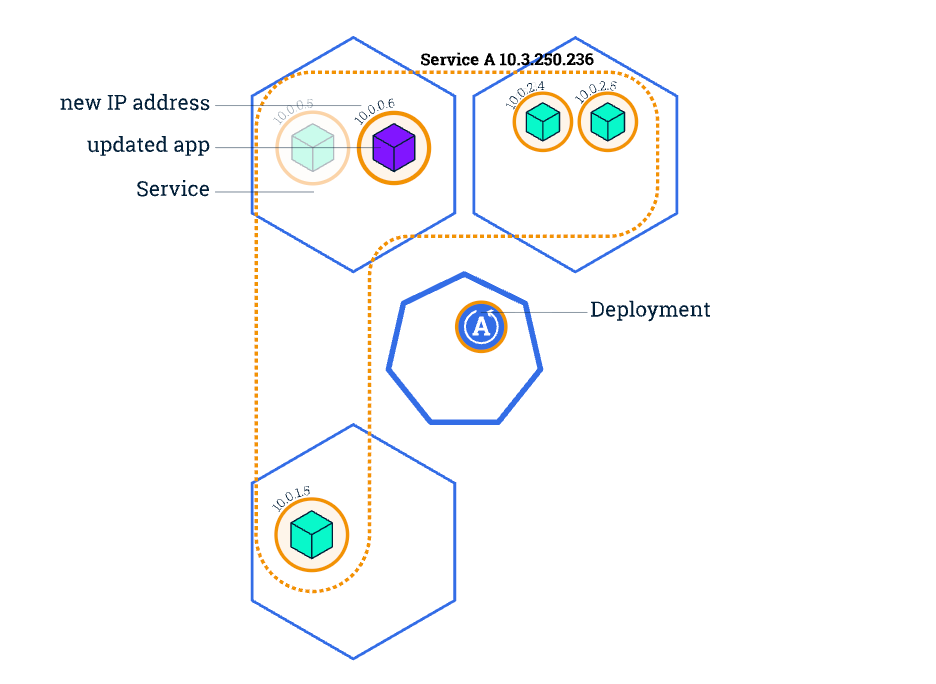 https://kubernetes.io/ja/docs/tutorials/kubernetes-basics/update/update-intro/
ReplicaSetは、あくまで同一Podの複製なので、新旧Podをローリングアップデートするには、ReplicaSetを管理するもう1つ上のリソースが必要であり、それがDeploymentになります。
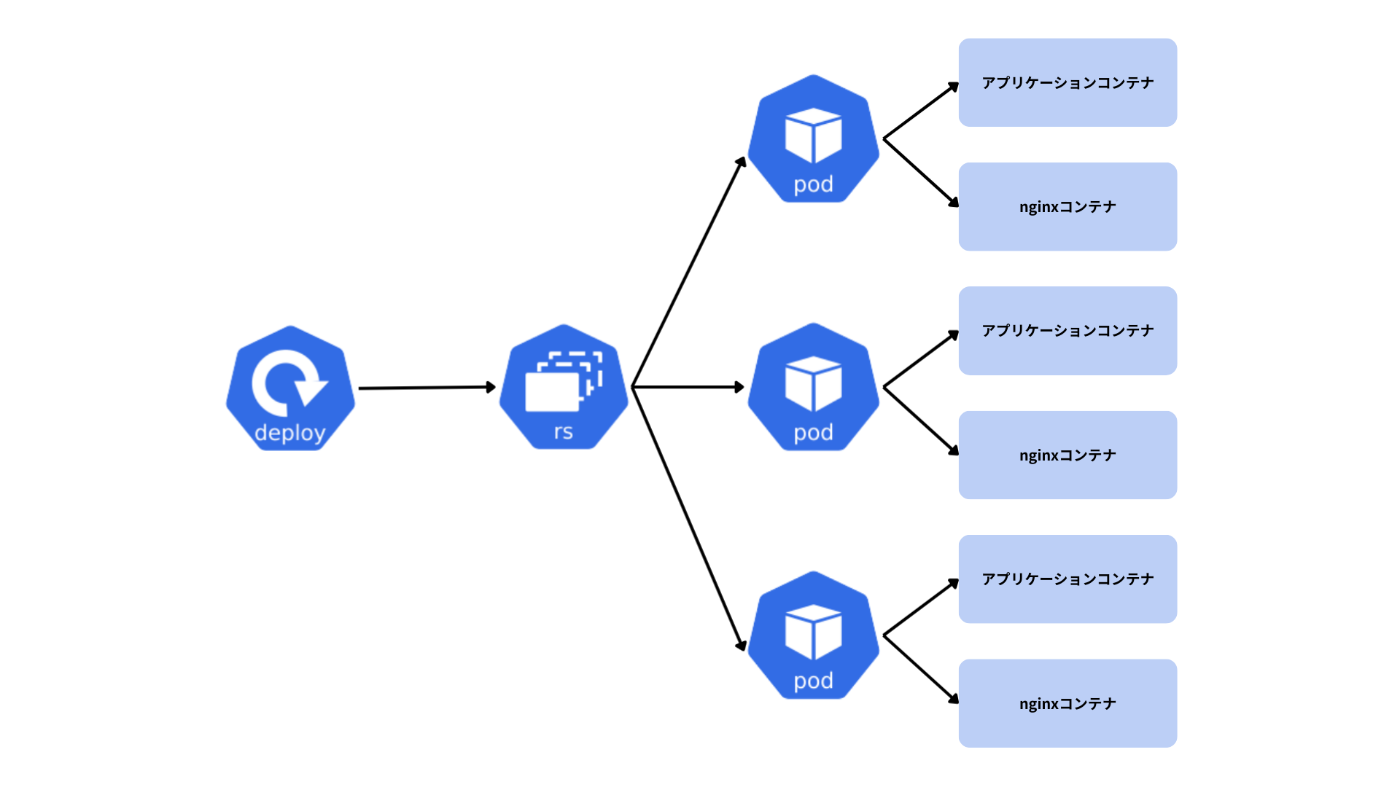
Service
Pod内のコンテナはループバック経由(localhost)での通信が可能です。そして、Podはクラスタ内でユニークなIPアドレスを持っています。つまり、Pod間は通信が可能ということになります。
そこで、あるPod-Aから、Pod-Bにアクセスしたいという状況を考えてみます。
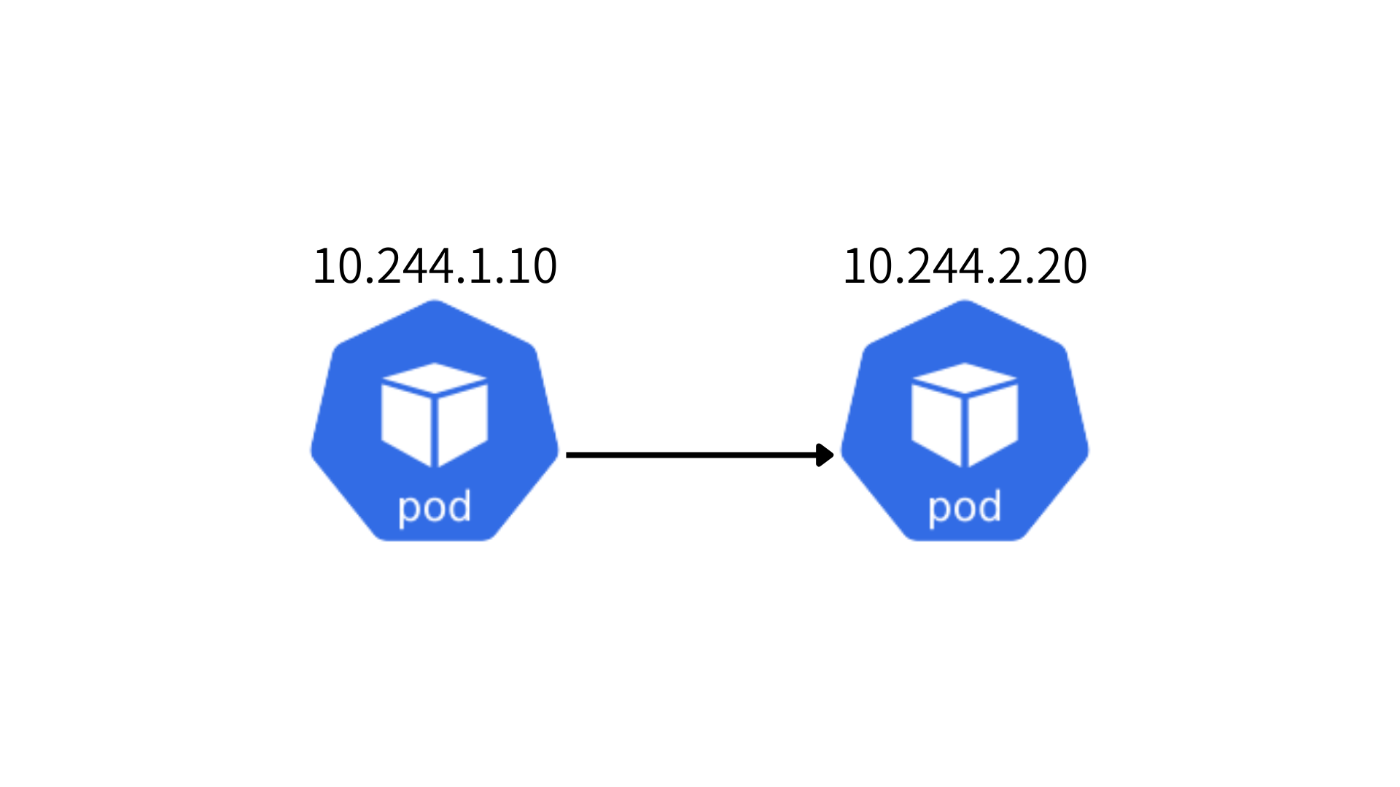
Pod-BのIPアドレスを直接指定すれば良いです。
しかしながら、先述したように、Podは再作成される短命なリソースです。再作成された場合、その新たなPodには新しいIPアドレスが付与されます。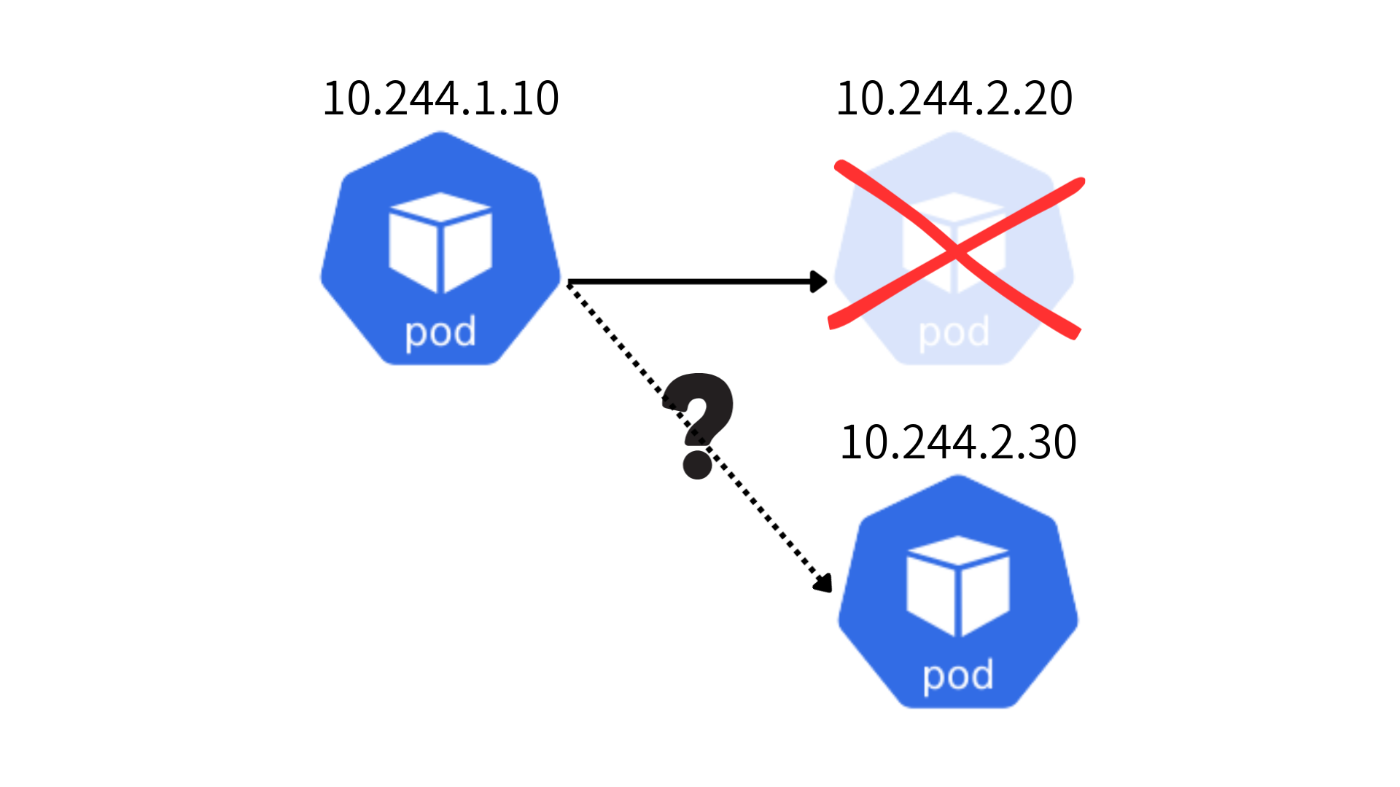
つまり、Podが持つIPアドレスを見て通信していては、再作成されたときに追従できず通信が不可能になってしまいます。
この問題を解決するのがServiceリソースです。 Serviceが提供する機能性として以下2つを取り上げます。
- Pod群に紐づく安定したDNS名を持つ、通信の抽象レイヤー
- クラスタ内外への通信の公開
Pod群に紐づく安定したDNS名を持つ、通信の抽象レイヤー
直接Pod-Bに通信するのではなく、関連づけられたServiceに対して通信するように構成することができます。
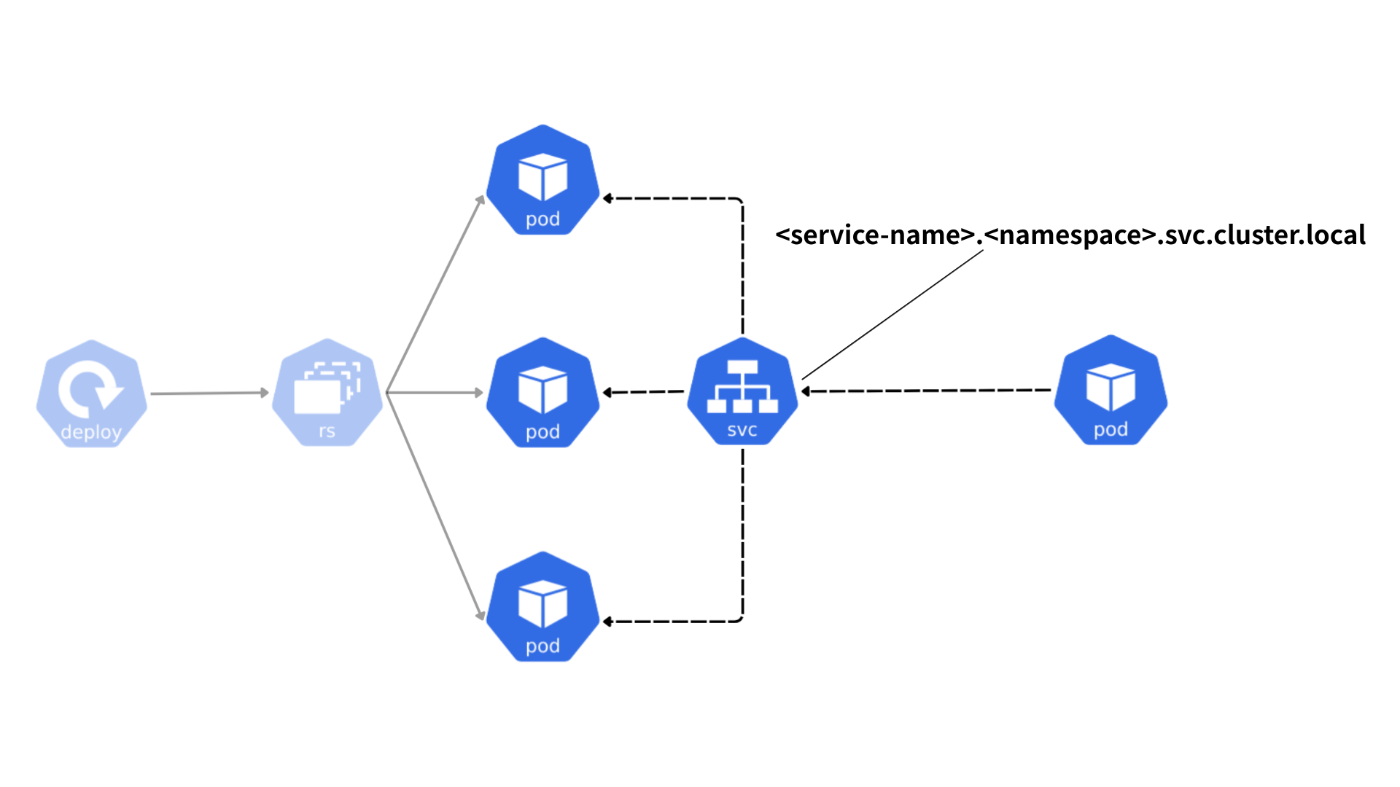
Serviceは、<service-name>.<namespace>.svc.cluster.localという規則でDNS名を持っています。
このDNSによる名前解決を可能にしているのは、CoreDNSというadd-onのリソースになります。 ServiceのDNS名に対してClusterIPもしくは PodのIPアドレスを応答します。
EKSでも、デフォルトでこのCoreDNSのPodが起動するようになっています。
もう少し深掘ります。 Serviceには、Endpoints/EndpointSliceというリソースが紐づいています。ここではEndpointSliceリソースを扱います。
Endpointsが元来存在したものです。EndpointSliceは、Endpointsの持っていたパフォーマンス的な課題を解決するために実装された新たなリソースになります。
EndpointSliceリソースには、Serviceとそれに紐づく全てのPodへのIPアドレス:ポートの情報が格納されています。ちなみに、このルーティング情報を格納するのは、EndpointSlice Controller(Control Plane)になりますがこれについては後述します。
リソースの関係性としては、以下のように表せます。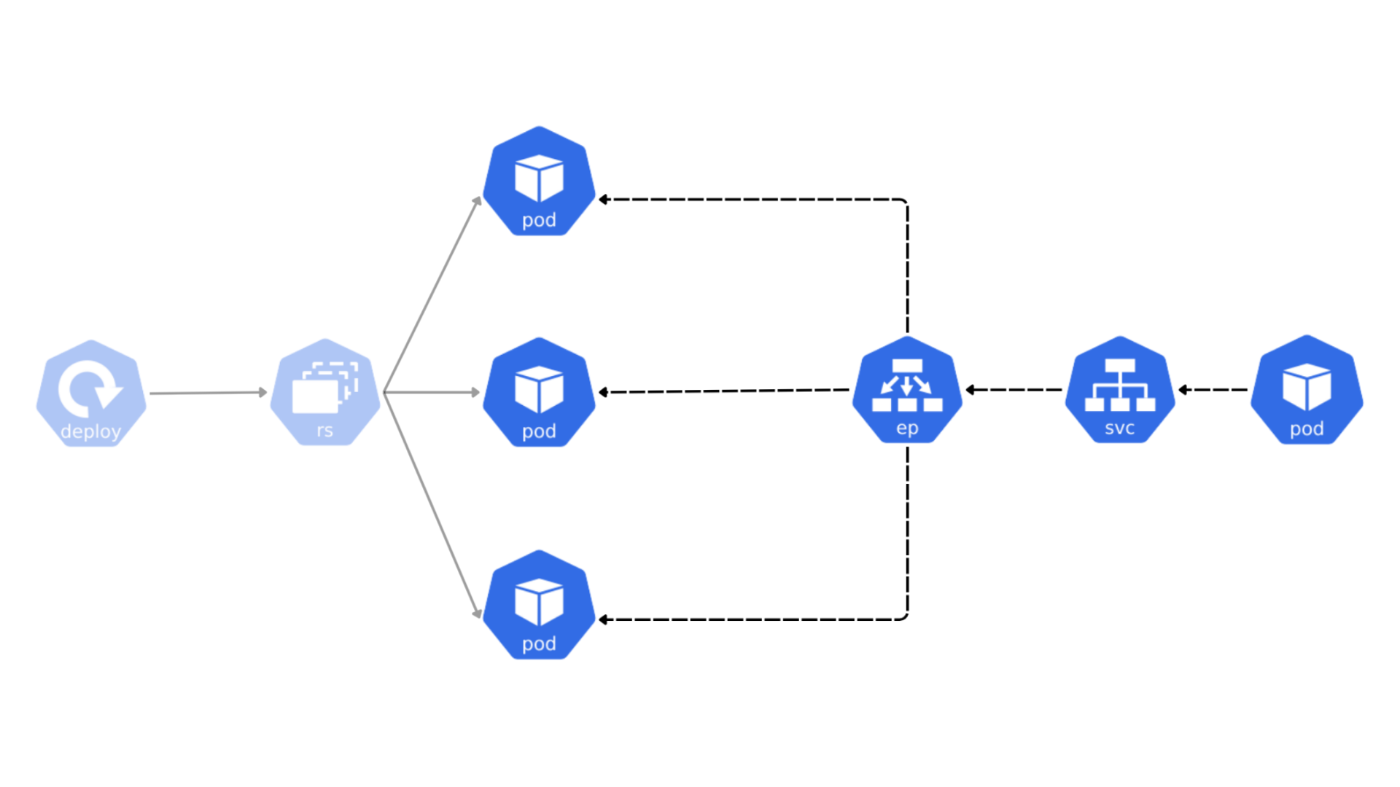
さらには、EndpointSlice自体がルーティングをしているわけではなく、このEndpointSliceの情報を見て、kube-proxyというコンポーネントがネットワーク設定をiptablesコマンドで設定しており、実際のネットワーク処理はLinuxカーネルに任せています。これについても後述します。
クラスタ内外への通信の公開
Serviceにはタイプがあり、それによってクラスタ内へも外へも通信を公開することができます。
クラスタ内への公開:ClusterIP
デフォルトのタイプになります。実はこれはすでに上で扱っていたことで、Serviceという通信の抽象レイヤーを介してPodにアクセス可能になるというものです。
Serviceには、ClusterIPというクラスター内における仮想のIPアドレスが付与されます。そして、CoreDNSによって<service-name>.<namespace>.svc.cluster.localといったDNS名からClusterIPに名前解決されるため、別PodからはDNS名でアクセスできるのでした。
なお、このClusterIPは外部からアクセスしても有効ではありません。
クラスタ外への公開:NodePort, LoadBalancer
NodePortタイプでは、各Worker Nodeに共通のポート(NodePort)を開放し、そのポートへの通信をServiceに転送することで、クラスタ内のPodへの通信を外部に公開します。
PodやServiceなどのリソースは、k8sが管理しているネットワーク空間におけるものです。そのネットワークの窓口的存在としてServiceが立ち、それがWorker Nodeのportと紐づくことで、k8sのネットワークと外部ネットワークが橋渡しされるようになります。
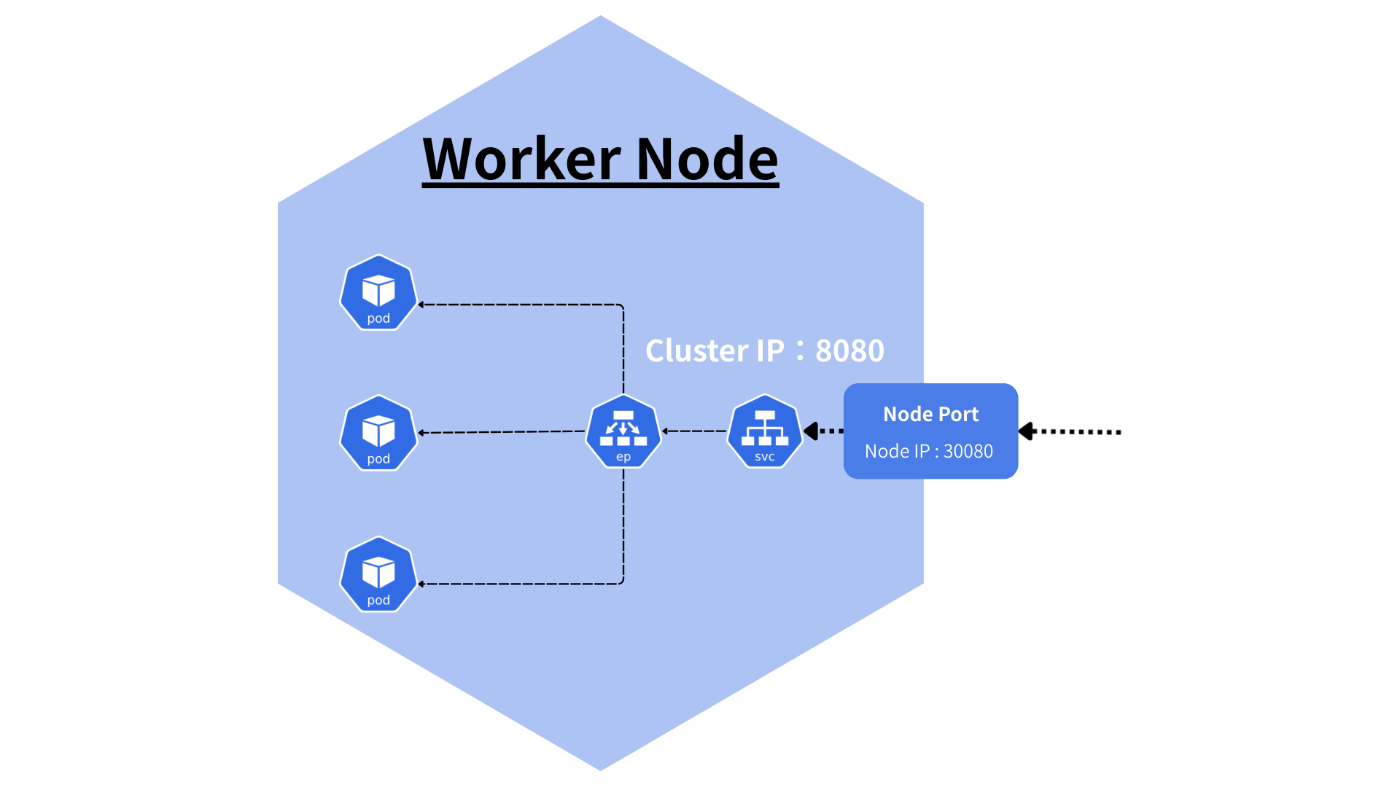
Worker Nodeもクラスタの内部なのに、Worker NodeのPortは外部と通信が可能なのか.....? と疑問に思うかもしれません。これは、Worker Nodeが論理的にはk8sクラスタの一部でありつつ、物理的・ネットワーク的にはクラウドやホストOS上に存在する1台のマシン(VM/コンテナ)だからです。
EKSの場合、EC2のサーバーインスタンスがWorker Nodeとして利用されます。
LoadBalancerタイプだと、クラウドプロバイダのAPIを叩くことでService用にロードバランサーがプロビジョニングされるようになります。K8sリソースによって、AWSリソースであるNLB(Network Load Balancer)の作成が指示されるといった感じです。
実際は、同様にNodePortで通信が公開されており、それをうまくLoadBalancerと紐づけてくれるServiceタイプであると言えそうです。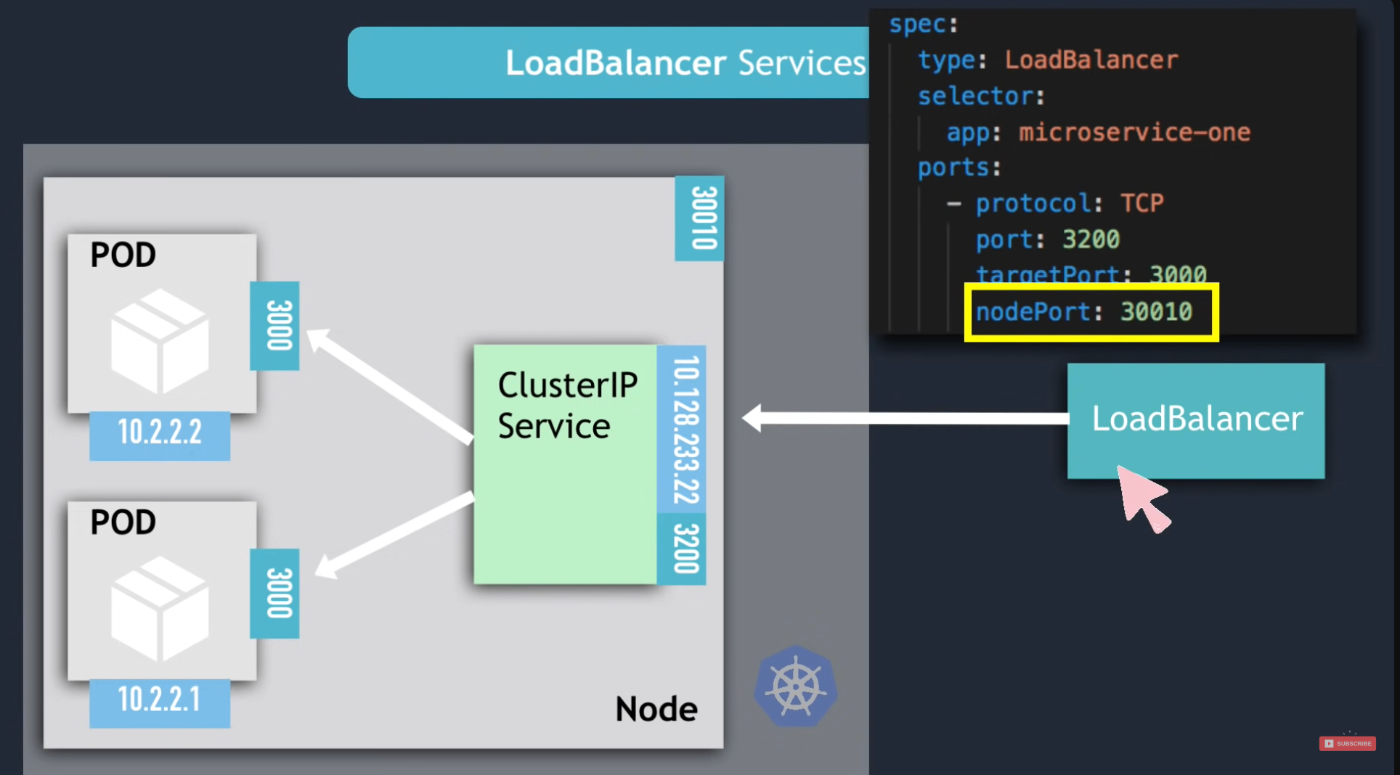 https://youtu.be/T4Z7visMM4E?si=bYFnY6xRJolmE6E0 より抜粋
ExternalName
Serviceが、k8sネットワーク内の通信を抽象化してくれることを述べましたが、このtypeは、その一点のみをサポートしてくれます。 Podへの転送は行わず、DNSレベルでCNAME(ドメイン名)を返すだけの仕組みになっています。
これは、外部サービスのエンドポイントをExternalName Serviceで抽象化して、具体エンドポイントを隠蔽するなどの用途で使われるようです。
以下はPodはserviceのFQDNさえ知っていれば良いということを表す図です。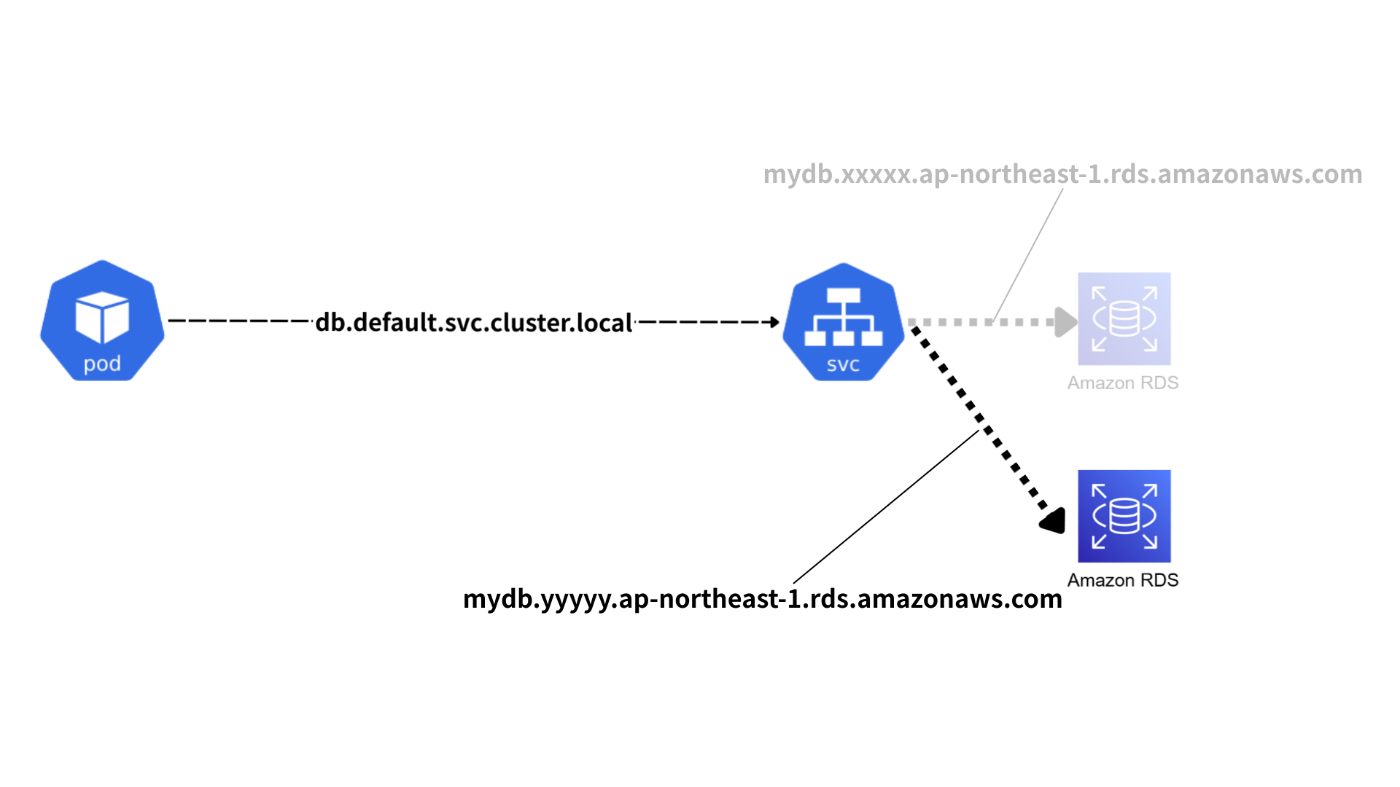
Ingress
Serviceは、L4(TCP/UDP)の通信の抽象化を実現します。一方、Ingressという、L7(HTTP/HTTPS)のルーティングルールを宣言的に定義するためのリソースもあります。本来TerraformなどでALBに設定するL7のルーティングルールを、k8s manifestにIngressとして記述できるようになるようです。
Worker Node
それでは、Podが動く実行環境であるWorker Nodeの中に存在するコンポーネントについてみていきます。 Podはコンテナ群を束ねているものでした。つまり、実質的にはコンテナの実行を任されているNodeになります。
Worker Nodeは、Pod(ひいてはコンテナ)を実行するための「器」のようなものとイメージすると良いかと思います。 Worker Nodeの持つCPUやメモリなどのリソース状況(「空き容量」)等をみて、Control Plane(後述)によってPodの配置がスケジューリングされます。
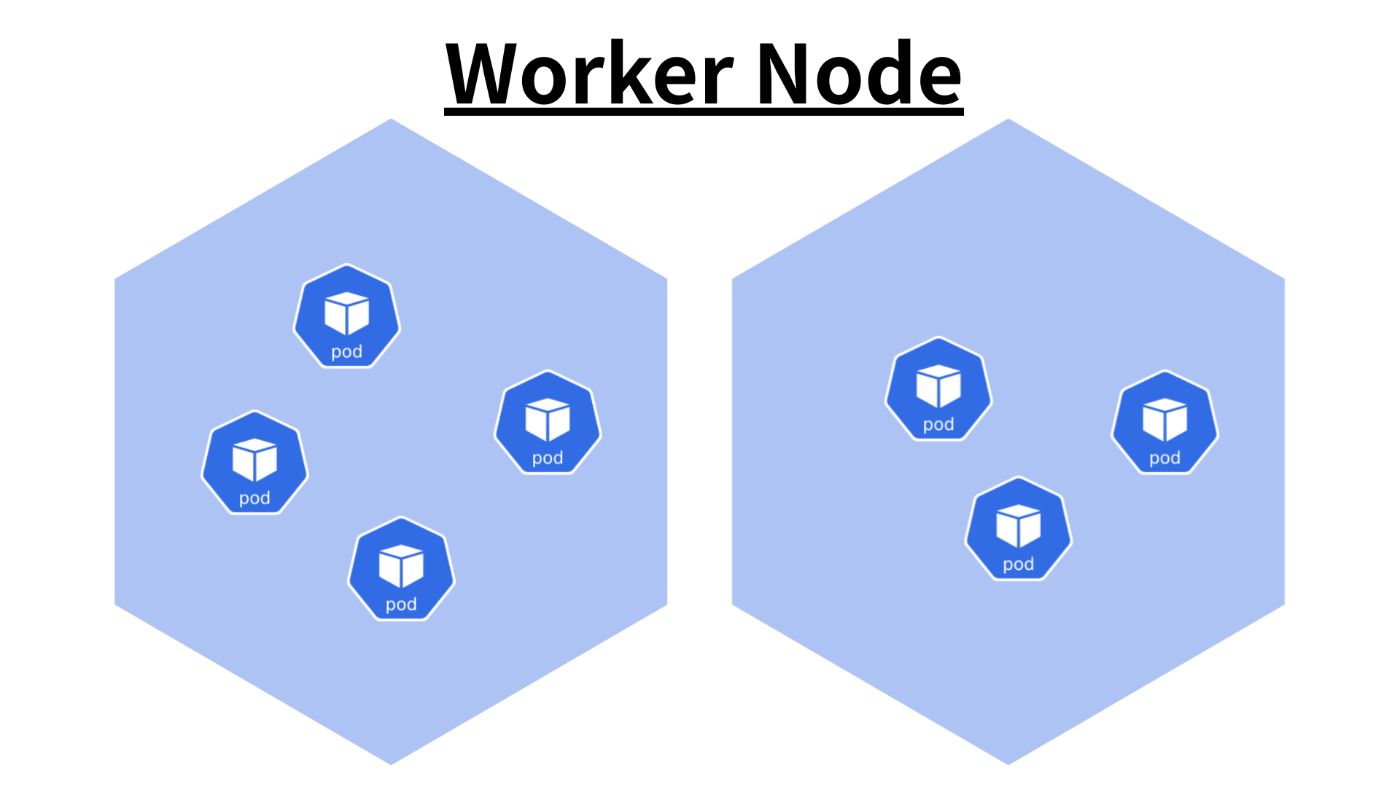
また、ラベルセレクター等で指定しない限りは、namespaceの境界なくPodがNodeにスケジュールされるようになっています。
kubernetesにはnamespaceの概念があり、1クラスター内でリソース分割を行うことができます。kubectlコマンドでPod等のリソースを操作するにしても、指定したnamespace単位で行うことになります。
なので、namespace によって概念的・論理的には分離されているPodリソースであっても、物理的にはWorker Node上で混在して実行されるという感じですね。
Worker Nodeには、以下のコンポーネントが含まれます。
- コンテナランタイム
- kubelet
- kube-proxy
順番に見ていきましょう。
コンテナランタイム
コンテナを実行するためには、コンテナランタイムが必要です。ここでは、コンテナランタイムという表現は高レベルのコンテナランタイム(前章を参照)を指します。
前章では、OCIという規格によって、コンテナイメージ、レジストリ、ランタイムの仕様が標準化されていることを述べました。
ここでは、さらにk8sがコンテナランタイムを扱うためのインターフェースが規格化されている点に注目します。
CRI
先は、「k8sがコンテナランタイムを扱う」と雑に表現しました。ちゃんと表現し直すと、k8sの中のkubeletというコンポーネントがコンテナランタイムを操作します。
そこで、kubeletが多様なコンテナランタイムを扱うためのインターフェースが、Container Runtime Interface(CRI)です。
この「インターフェース」の実態は、kubeletとやりとりするためのgRPCプロトコル定義になります。以下で定義されているエンドポイントを用意されていれば、コンテナランタイムが何であれ理論上はkubeletと通信することが可能になります。
前章ではOCIという似たような響きの言葉が出てきました。整理してCRIを付け足すと以下のようになります。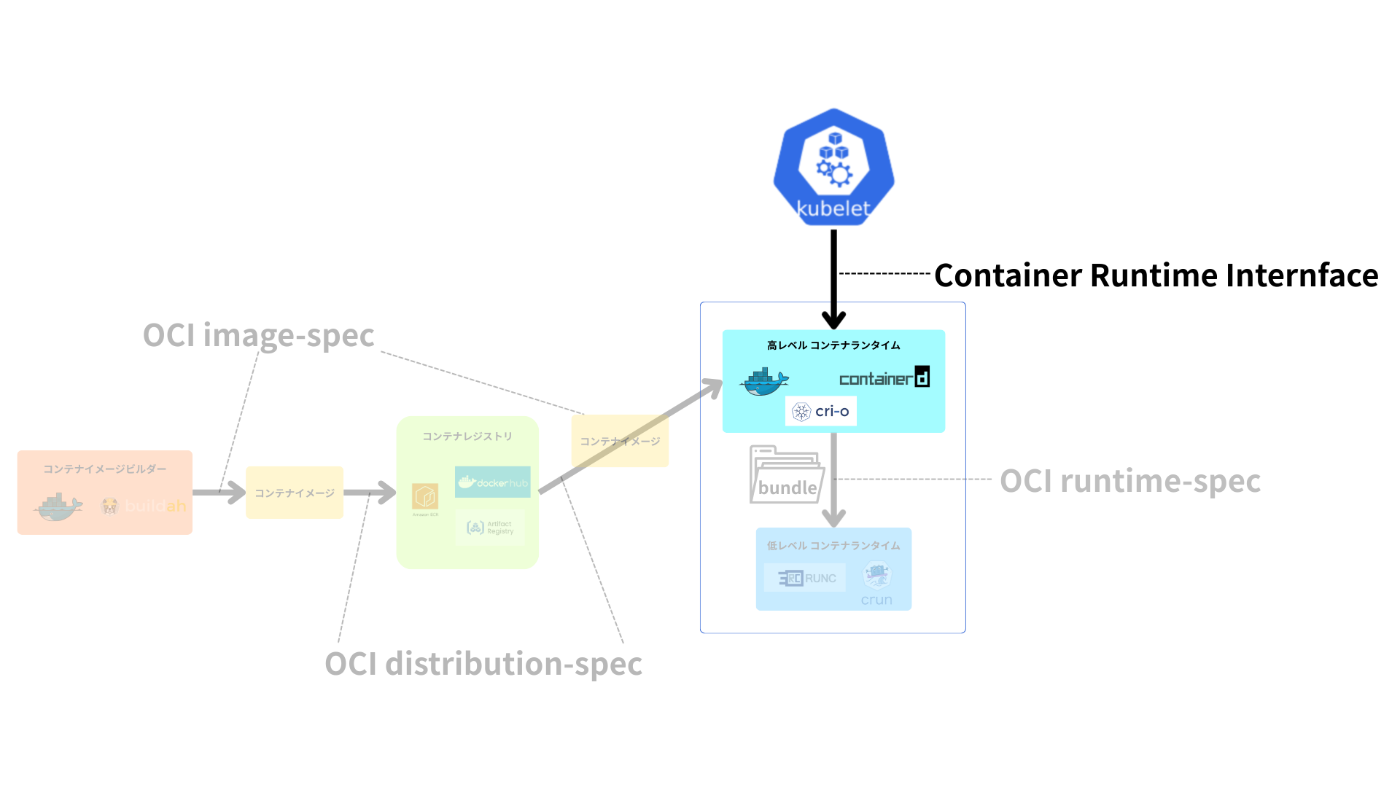
CRIに対応しているコンテナランタイムは以下のようなものがあります。
- containered
- CRI-O
EKSは、コンテナランタイムをDocker Engineからcontainerdに移行したようです。
これは前章で説明した、Docker Engineと比較したときのcontainerdのシンプルさゆえというのも1つありますが、CRIに関わる文脈も大きそうです。
Docker Engine単体ではCRIに対応しておらず、かつてはk8s側でdockershimというアダプターを利用するという実装が組み込まれていました。
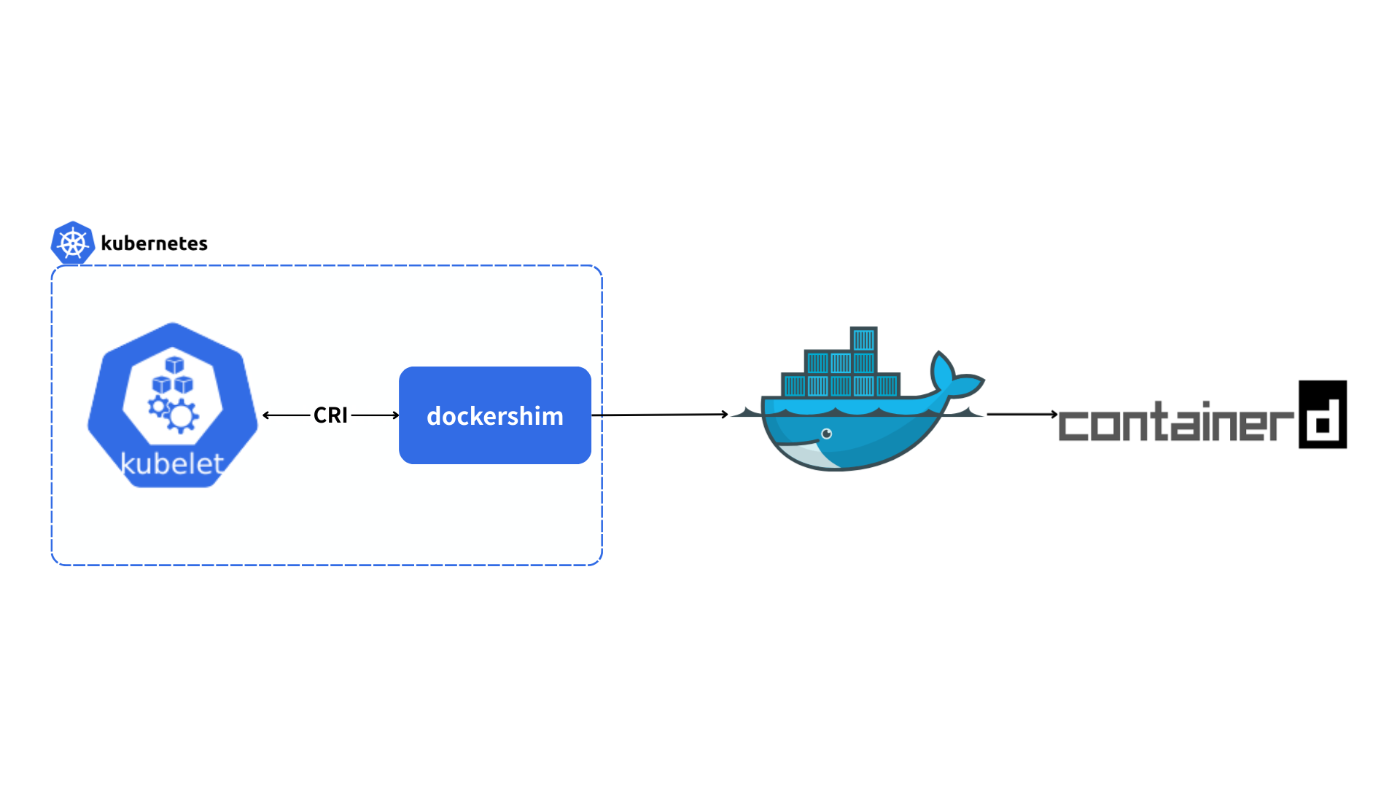
k8sでは、当初Docker Engineでのみ動作していました。その後、多様なランタイムに対応するためにCRIができます。そして、CRI互換でDocker Engineを扱えるように、後からdockershimの実装をk8sに用意したという経緯があるようです。
しかし、メンテナンス等の理由で、k8sからdockershimの実装が削除されました。
このようにEKSでcontainerdに移行したのはいい、CRI互換のために実装されていたdockershimがk8sから削除され、これまで通りDocker Engineを使うことができなくなったことがきっかけと言えそうです。
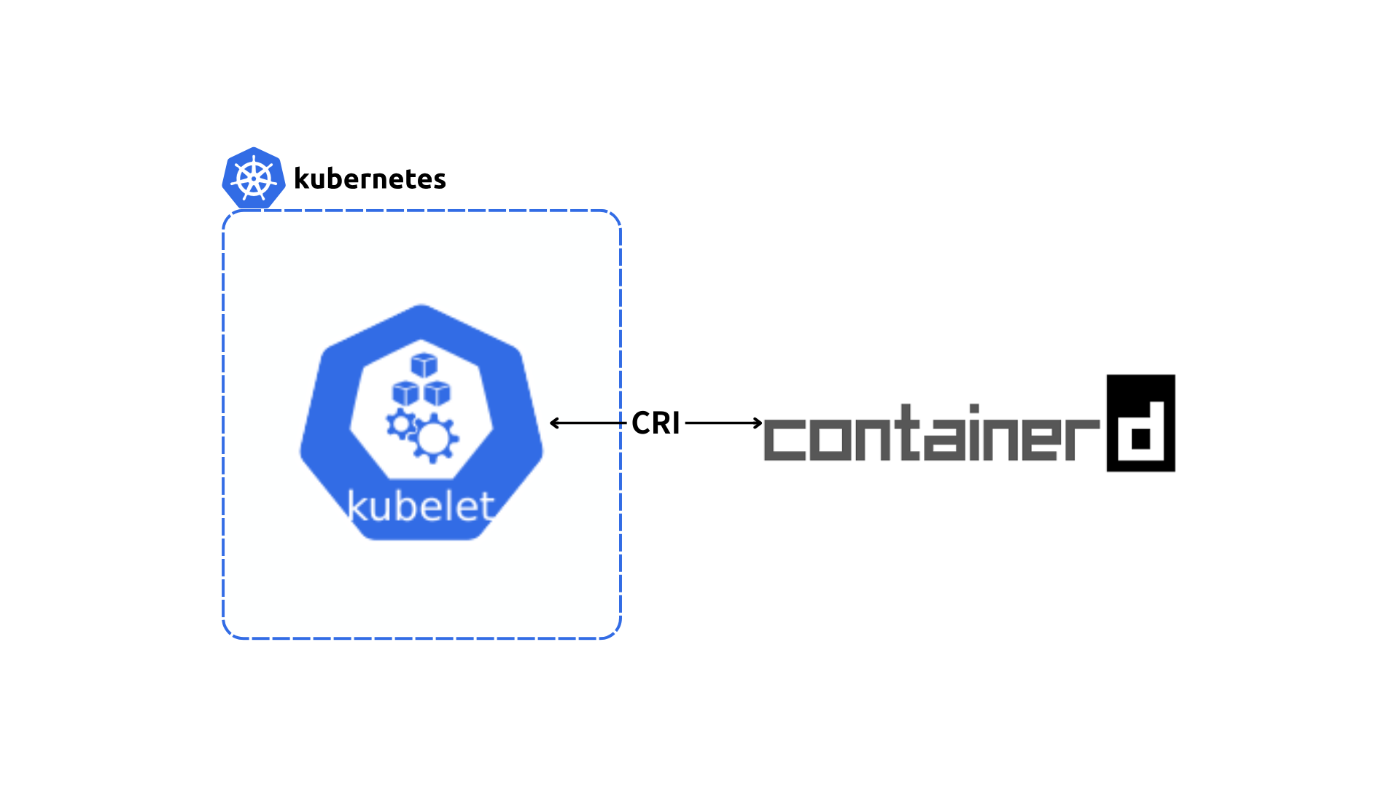
なお、kubeletが扱えるランタイムからDocker Engineが外れたわけではありません。 Nodeにアダプタをインストールして利用すればDocker Engineでも構いません。
kubelet
kubeletは、各Worker Node上で動く主要なエージェントであり、クラスタにおける司令塔であるContorol Planeとの通信を行います。
通信の流れは基本的に、kubelet→Controle Planeの一方通行です。
- Worker NodeをControl Planeに登録
- Control PlaneからPullしたPodSpecを元にPodの状態を管理
- Pod/Worker Nodeの状態をControl PlaneにPush
Worker NodeをControl Planeに登録
Control Planeの内部にあるコンポーネントでkube-api-server(以下、api-server)というものがあります。
kube-api-server = 「Control Planeと外部(Worker Nodeも含む)がやり取りするための窓口」と捉えておいてください。詳しくは後述します。
kubeletは、以下の流れで動作しているWorker Nodeをapi-serverに登録します。ざっくりコードも追ってみましょう。
// kubernetes/pkg/kubelet/kubelet_node_status.go
// registerWithAPIServer registers the node with the cluster master. It is safe
func (kl *Kubelet) registerWithAPIServer() {
 // 省略

 //kubelet自身が動くマシン自体をWorker Nodeオブジェクトとして返す
 node, err := kl.initialNode(context.TODO())
 // Worker Nodeを実際にapi-serverに登録
 registered := kl.tryRegisterWithAPIServer(node)
}
initialNode()
kubeletが動作するマシン上の情報を詰めています。
// kubernetes/pkg/kubelet/kubelet_node_status.go
func (kl *Kubelet) initialNode(ctx context.Context) (*v1.Node, error) {
	node := &v1.Node{
		ObjectMeta: metav1.ObjectMeta{
			Name: string(kl.nodeName),
			Labels: map[string]string{
				v1.LabelHostname:      kl.hostname, // 実際はos.Hostname()の値が割り当てられている = マシンのホスト名
				v1.LabelOSStable:      goruntime.GOOS, // マシンのOS
				v1.LabelArchStable:    goruntime.GOARCH, // マシンのアーキテクチャ
				kubeletapis.LabelOS:   goruntime.GOOS,
				kubeletapis.LabelArch: goruntime.GOARCH,
			},
		},
	}
api-serverはAPIサーバーです。kubeletはPOST /api/v1/nodesを叩いてNodeを登録しています。
tryRegisterWithAPIServer()
// kubernetes/pkg/kubelet/kubelet_node_status.go
func (kl *Kubelet) tryRegisterWithAPIServer(node *v1.Node) bool {
    // POST /api/v1/nodes
	_, err := kl.kubeClient.CoreV1().Nodes().Create(context.TODO(), node, metav1.CreateOptions{})

    // 省略
}
api-serverはこのPOSTリクエストを受け取り、Nodeの情報をetcdに保存します。このetcdへの保存がWorker Nodeの登録を意味します。
etcdは、Control Planeのコンポーネントであり、k8sリソースの情報を永続化するためのキーバリューストアになります。 NodeだけでなくPodの情報やDeployment、Serviceリソースの情報が保存されます。このコンポーネントについても後述します。
実際は値がエンコードされますが、以下のようにKey-ValueでNodeの情報が保存されるイメージです。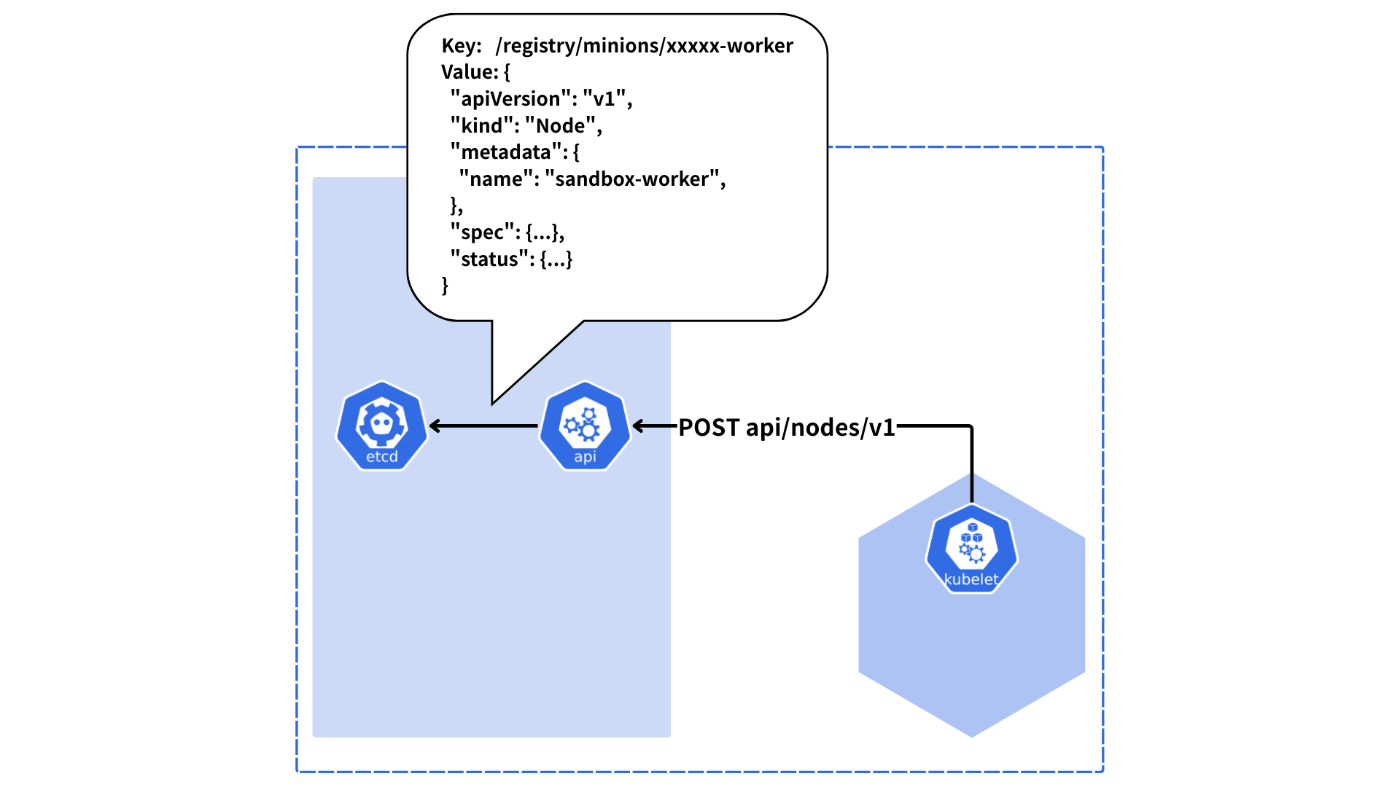
図解では、Keyを/registry/minions/xxxxx-workerとして表現しています。これは実際にetcdのpodに入ってみたkey名なのですが、nodesではなくminionsという名前になっているのが気になりますね。
これは、初期にnodeがminionという名前だった名残のようです。etcdに保存するkey名には古い名前がまだ利用されているようですね。
- 参考:標準化用語集
Control PlaneからPullしたPodSpecを元にPodの状態を管理
kubeletは、api-serverにPodオブジェクトを問い合わせ、あるべき状態を把握します。 api-serverからPushされるわけではありません。
PodSpecとは、その名の表す通りであり、Podのあるべき状態であり、Podオブジェクトに含まれます。
以下は、kubeletの中で呼ばれる、api-serverからPodオブジェクトをPullするための関数です。
// /kubernetes/pkg/kubelet/config/apiserver.go
// NewSourceApiserver creates a config source that watches and pulls from the apiserver.
func NewSourceApiserver(....){
    // このノードに割り当てられたPodを監視するためのListWatch作成
    // GET /api/v1/pods?fieldSelector=spec.nodeName=xxx
 	lw := cache.NewListWatchFromClient(c.CoreV1().RESTClient(), "pods", metav1.NamespaceAll, fields.OneTermEqualSelector("spec.nodeName", string(nodeName)))

    go func() {
        logger.Info("Watching apiserver")
        // Reflectorを起動してWatch API を開始
        // LIST(初期データ) → WATCH(ストリーム接続でイベント継続受信)
        newSourceApiserverFromLW(lw, updates)
    }()
}
叩くエンドポイントは、GET /api/v1/podsになります。初回にGET /api/v1/pods?fieldSelector=spec.nodeName=xxxのようにリクエストしてそのWorker Nodeに割り当てられた全Podのスナップショットを取得します。
LIST responseイメージ
{
  "kind": "PodList",
  "apiVersion": "v1",
  "metadata": {
    "resourceVersion": "12345"  ← この時点のスナップショット
  },
  "items": [
    {
      "metadata": {"name": "nginx-pod", "namespace": "default"},
      "spec": {"nodeName": "xxxx", ...},
      "status": {"phase": "Running", ...}
    },
    {
      "metadata": {"name": "app-pod", "namespace": "default"},
      "spec": {"nodeName": "xxxx", ...},
      "status": {"phase": "Running", ...}
    },
    {
      "metadata": {"name": "db-pod", "namespace": "prod"},
      "spec": {"nodeName": "xxxx", ...},
      "status": {"phase": "Pending", ...}
    }
  ]
}
そのあとはクエリパラメータにwatchをつけて、GET /api/v1/pods?watch=true&fieldSelector=spec.nodeName=xxxxx&resourceVersion=12345のようにリクエストして、api-serverから変更イベントを受け取ります。
k8sで"watch"とは、streaming処理を指すとあります。
in the Kubernetes API, watch is a verb that is used to track changes to an object in Kubernetes as a stream. It is used for the efficient detection of changes.
https://kubernetes.io/docs/reference/using-api/api-concepts/
api-server側には、レスポンスをTransfer-Encoding: chunkedで返すようになっているハンドラがありました。クエリパラメータがwatch=trueである場合はこのハンドラが利用されるみたいです。
// staging/src/k8s.io/apiserver/pkg/endpoints/handlers/watch.go
// HandleHTTP serves a series of encoded events via HTTP with Transfer-Encoding: chunked.
// or over a websocket connection.
func (s *WatchServer) HandleHTTP(w http.ResponseWriter, req *http.Request) {
    // 省略
    // begin the stream
	w.Header().Set("Transfer-Encoding", "chunked")
	// 省略
}
WATCH responseイメージ
// Pod追加イベント
{
    "type": "ADDED",
    "object": {
        "kind": "Pod",
        "apiVersion": "v1",
        "metadata": {
            "name": "new-nginx",
            "namespace": "default",
            "uid": "abc-123",
            "resourceVersion": "12346"
        },
        "spec": {
            "nodeName": "xxxx",
            "containers": [
                {
                    "name": "nginx",
                    "image": "nginx:1.21"
                }
            ]
        },
        "status": {
            "phase": "Pending"
        }
    }
}
streamingになっていることによって、kubeletはapi-serverをpollingし続けることなく、かつリアルタイムに状態変化を観測できるわけですね。
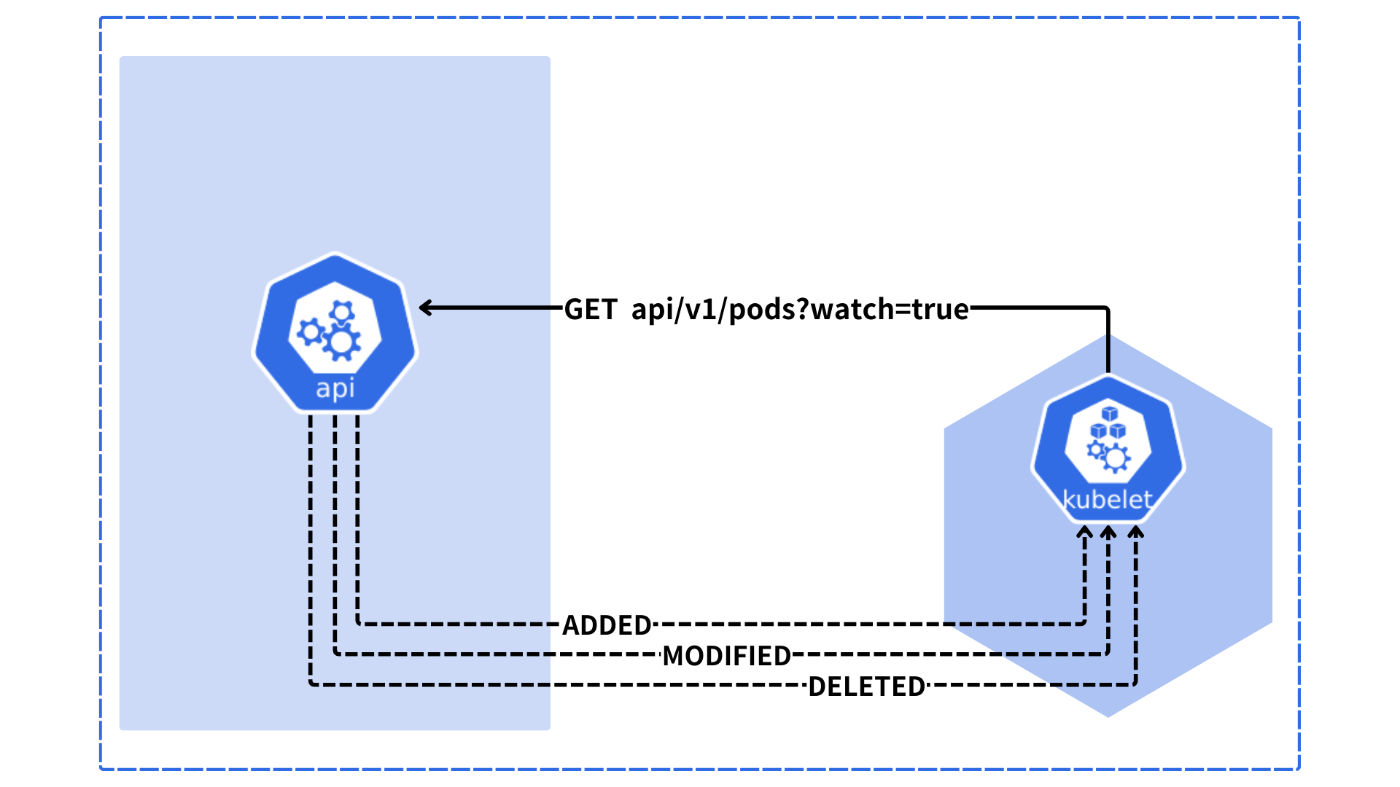
そして、これらの状態変化イベントをもとに、kubeletは現在の実行状態とPodSpecを突き合わせ、差分があればreconcileを行います。例えば、あるPodに対するMODIFIEDイベントが送られてきた場合は、goroutineによる非同期処理で変更を適用させます。
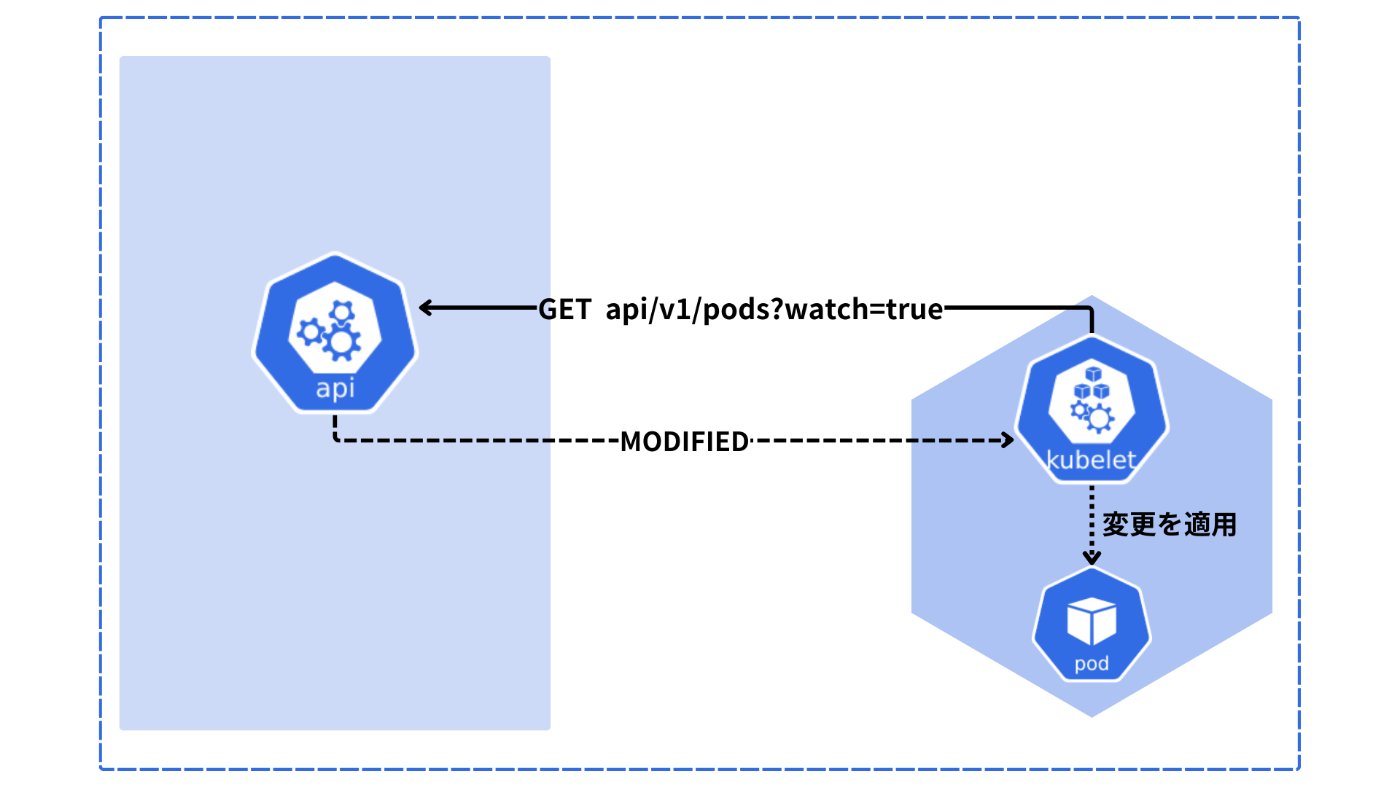
MODIFIEDイベントの全てがPodSpecの変更なわけではありません。
Pod/Worker Nodeの状態をControl PlaneにPush
今まであげた2点と同じく、エンドポイントを叩いてapi-serverにPod/Nodeの状態(status)を報告します。このstatusは、api-serverを介してetcdに保存されます。
以上3点を挙げましたが、他にも以下のような機能性を持ちます。
- Liveness Probe
- コンテナのヘルスチェック
- Readiness Probe
- コンテナがトラフィックを受け付けられる状態をチェック
他にもありますが、ここまででkubeletがWorker Nodeの心臓部といっても差し支えない、重要な存在であることがわかりました。
kube-proxy
kube-proxyは、ネットワークのルールを設定します。
なおkube-proxyはDaemonSetとして展開されています。 DaemonSetとは、各Node上で1つずつPodが起動することを保証するリソースです。
なので、kubectl get pods -n kube-systemで確認すればkube-proxyのpodが確認できます。
ネットワークルールの設定
kube-proxyはService/EndpointSliceリソースをwatchします。この辺の仕組みは、kubeletがPodリソースをwatchしていた仕組みと同じなので詳細は割愛します。
この2つのリソースの情報を利用し、iptablesルールへの反映をすることによってNodeにおけるネットワークのルーティング設定を行います。 Service宛のリクエストが適切にPodのIPアドレスに変換されるようになるのです。
kube-proxyの動作には3つのモードがあります。
ここでは、デフォルトであるiptablesモードを前提に扱います。
このモードにおいてkube-proxyは、Service/EndpointSliceリソースの情報をもとにiptablesルールを設定するという役割のみを担います。
iptables/netfileter
iptablesは、Linux カーネルのパケット処理ルール(→netfileter)を設定するためのCLIです。
...となれば、理解すべきはnetfileterですね(次から次へと知らない知識が....😖)。
netfilterは、以下の3つの概念で構成されます。
- table:
- 目的別にパケット処理を分類する論理的な単位
- 「このパケットに何をしたいか」という処理の目的を表す
- 例:
filter(許可)nat(アドレス/ポート変換)mangle(パケット改変)raw(conntrack制御)
- chain:
- パケットが通過する処理ポイント(フック)
- パケットのライフサイクル上の「どの処理段階で処理するか」を表す
- 例:
PREROUTING(ルーティング判定前)INPUT(ローカルプロセス宛てのパケット)FORWARD(他ホストへ転送されるパケット)OUTPUT(ローカルプロセスから送信されるパケット)POSTROUTING(ルーティング判定後)
- rule:
- 条件とアクションの組み合わせ
- chainの中に順序付きで並ぶ
- アクション例:
DNAT(宛先アドレス変換)SNAT(送信元アドレス変換)ACCEPT(パケットを通す)DROP(パケットを落とす)JUMP(chainを跨ぐ)
kube-proxyが操作するほとんどがnatテーブルになります。(次いでfilter, mangleテーブルになりそうです) ここではnatテーブルについて取り上げます。
以下のように設定されているものとイメージしましょう。
nat table
| hook | chain | rule(役割) |
|---|---|---|
| PREROUTING | PREROUTING | 宛先IP/Port条件で 別chainへJUMP |
| PREROUTING | DNAT-CHAIN | DNAT(宛先IP/Port書き換え) |
| 例:203.0.113.10:80 ⇨ 192.168.1.100:8080 | ||
| OUTPUT | OUTPUT | 自プロセス発の通信を 別chainへJUMP |
| OUTPUT | DNAT-CHAIN | DNAT(loopback含む) |
| POSTROUTING | POSTROUTING | 送信元IP条件で SNAT / MASQUERADE |
| 例:192.168.1.100:8080 ⇨ 203.0.113.10:80 |
203.0.113.10:80宛のパケットが送られてきた場合は以下のように以下のように宛先/送信元のアドレスが変換されるなどします。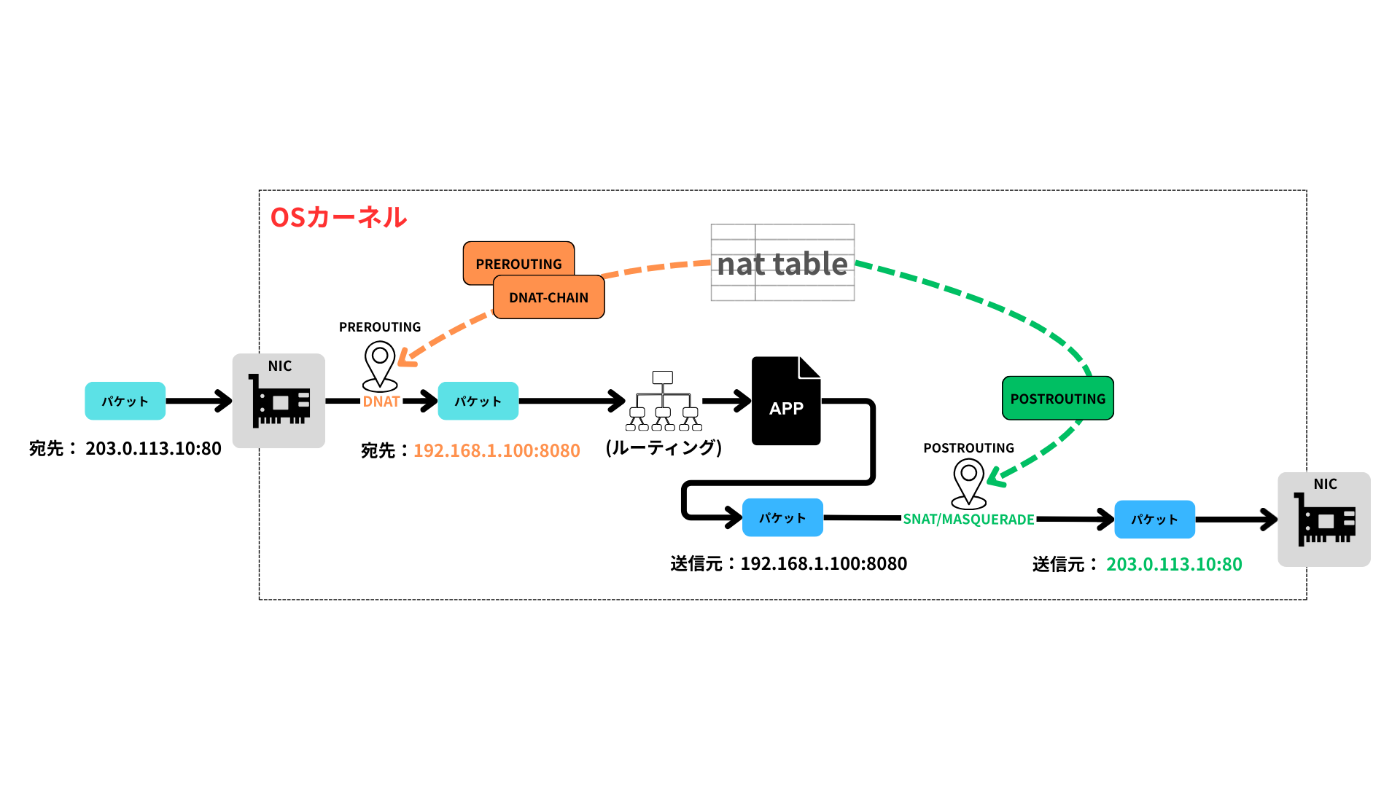
netfilterを通して、フック(パケットの処理段階)ごとに対応するchainのruleが動作するイメージです。ちなみに、上の表だとDNAT-CHAINは任意に設定したchain名になります。
また、ルーティング処理はカーネル内の別システムが担いますがここでは割愛します。Linuxカーネルがうまくやってくれるとだけ把握しておきましょう。
PodがReplicaset=3で起動している & NodePort(30080番) Serviceで公開している場合、kube-proxyは以下のようにnat tableを設定します(一部略)。
nat table
| hook | chain | rule |
|---|---|---|
| PREROUTING | PREROUTING | 全パケットを KUBE-SERVICES へ JUMP |
| PREROUTING | KUBE-SERVICES | 宛先が Service 関連(ClusterIP / NodeIP 等)なら Service 判定へ・ClusterIP → KUBE-SVC-xxxx・LOCAL(NodeIP) → KUBE-NODEPORTS |
| PREROUTING | KUBE-NODEPORTS | dst-port=30080(NodePort) → KUBE-EXT-yyyy |
| PREROUTING | KUBE-EXT-yyyy | 外部通信として MARK(SNAT が必要な場合)KUBE-MARK-MASQ Service chain へ JUMPKUBE-SVC-yyyy |
| PREROUTING | KUBE-SVC-yyyy | 確率ベースで Endpoint chain を選択 |
| PREROUTING | KUBE-SEP-aaaa | DNAT → PodIP:8010.244.1.2:80 |
| PREROUTING | KUBE-SEP-bbbb | DNAT → PodIP:8010.244.1.3:80 |
| PREROUTING | KUBE-SEP-cccc | DNAT → PodIP:8010.244.1.4:80 |
| POSTROUTING | KUBE-POSTROUTING | MARK された通信を MASQUERADE(SNAT) |
iptablesコマンドのutilsパッケージが用意されているのが以下からわかります。このパッケージは、主にkube-proxyが利用します。
// kubernetes/pkg/util/iptables/iptables.go
//go:build linux
package iptables

// 省略
func (runner *runner) runContext(ctx context.Context, op operation, args []string) ([]byte, error) {
	iptablesCmd := iptablesCommand(runner.protocol)
	fullArgs := append(runner.waitFlag, string(op))
	fullArgs = append(fullArgs, args...)
	klog.V(5).InfoS("Running", "command", iptablesCmd, "arguments", fullArgs)
	if ctx == nil {
		return runner.exec.Command(iptablesCmd, fullArgs...).CombinedOutput()
	}
    // os/execパッケージを用いてiptablesコマンド実行
	return runner.exec.CommandContext(ctx, iptablesCmd, fullArgs...).CombinedOutput()
	// Don't log err here - callers might not think it is an error.
}
kube-proxyの構造体のフィールド情報から、iptablesパッケージのインターフェースに依存していることがわかります。
// kubernetes/pkg/proxy/iptables/proxier.go
// Proxier is an iptables-based proxy
type Proxier struct {
    // 省略
    // utiliptablesはiptablesパッケージのalias
    iptables       utiliptables.Interface
}
iptablesはユーザー空間で利用するツールであるため、システムコールとかではなく、外部コマンド呼び出しになっている感じなんですね。
そして、NodeIP:30080でリクエストが来た場合、PREROUTINGフックを起点にchainを乗り継ぎ、以下のようにnetfilterが動作してPodへのIPが決まります。
最終的にはKUBE-SEP-ccccchainがDNATを行い、Pod IPへと変換している様子を表しています。
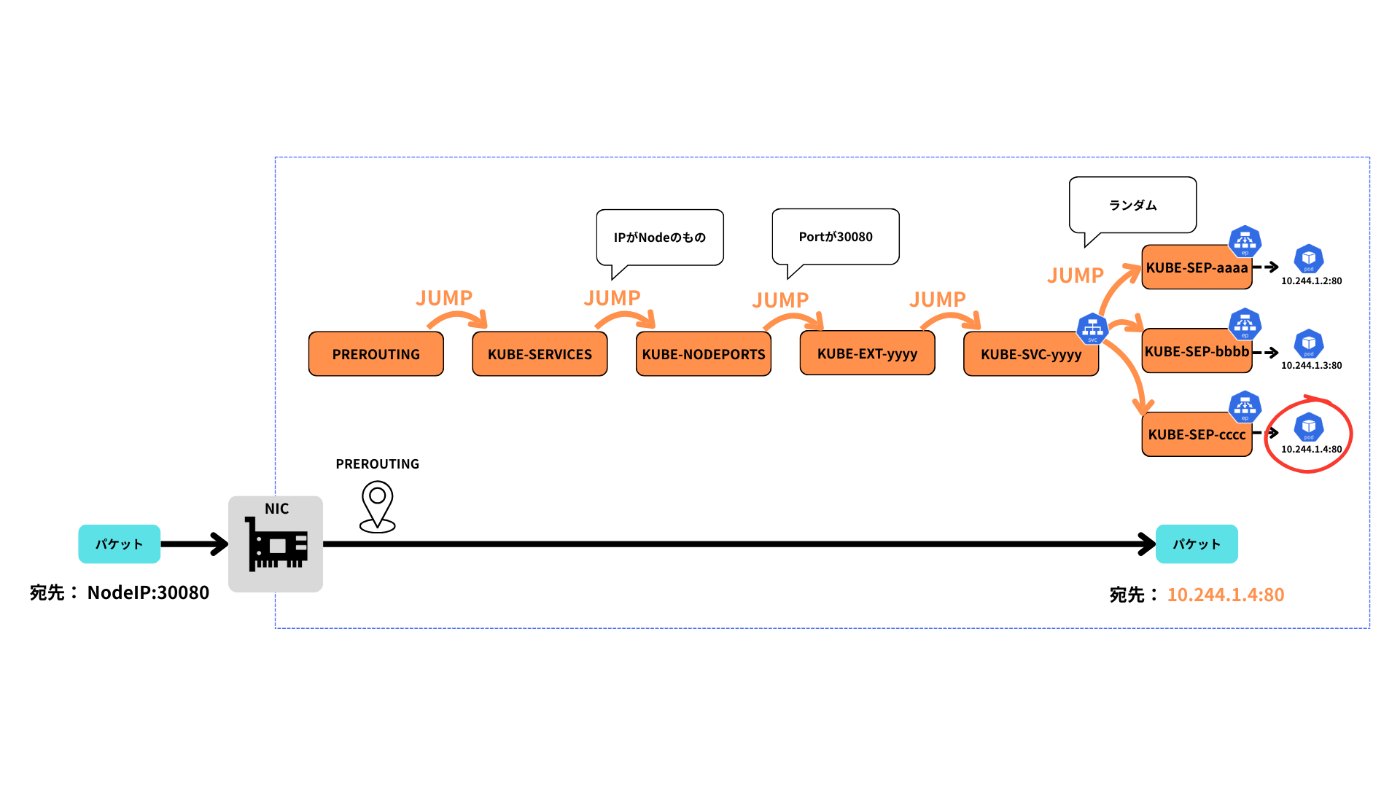
おさらいですが、EndpointSliceリソースが各PodへのIPアドレスを持っていて、EndpointSliceを束ねている上位レイヤーがServiceでした。iptablesでも同じように設定されていたんですね。
以下にまとめます。
- kube-proxyがService/EndpointSliceリソースをもとにiptablesを使い、Node上にネットワークルールを構築している
- Linuxカーネルがこれらのルールを適用することで、Service宛のリクエストがPodのIPアドレスに変換される
Control Plane
クラスター全体の状態を管理する、中枢コンポーネントであると言えます。このControl Plane ノードに含まれるコンポーネントについてみていきましょう。
- kube-api-server
- kube-controller-manager
- kube-scheduler
- etcd
kube-api-server
api-serverについては、これまでも登場しています。 kubelet,kube-proxyがspec(あるべき状態)をwatchしていました。
api-serverは、いわばクラスターの窓口的存在を担うHTTPサーバーであり、APIを提供します。
Worker NodeのコンポーネントはこのAPIを叩いて状態を問い合わせます。開発者もkubectlコマンドを用いてクラスター内の情報をみたり、操作したりが可能ですが、これもAPIを内部的に叩いているだけに過ぎません。
とてもわかりやすく表されている図解がありましたので引用します。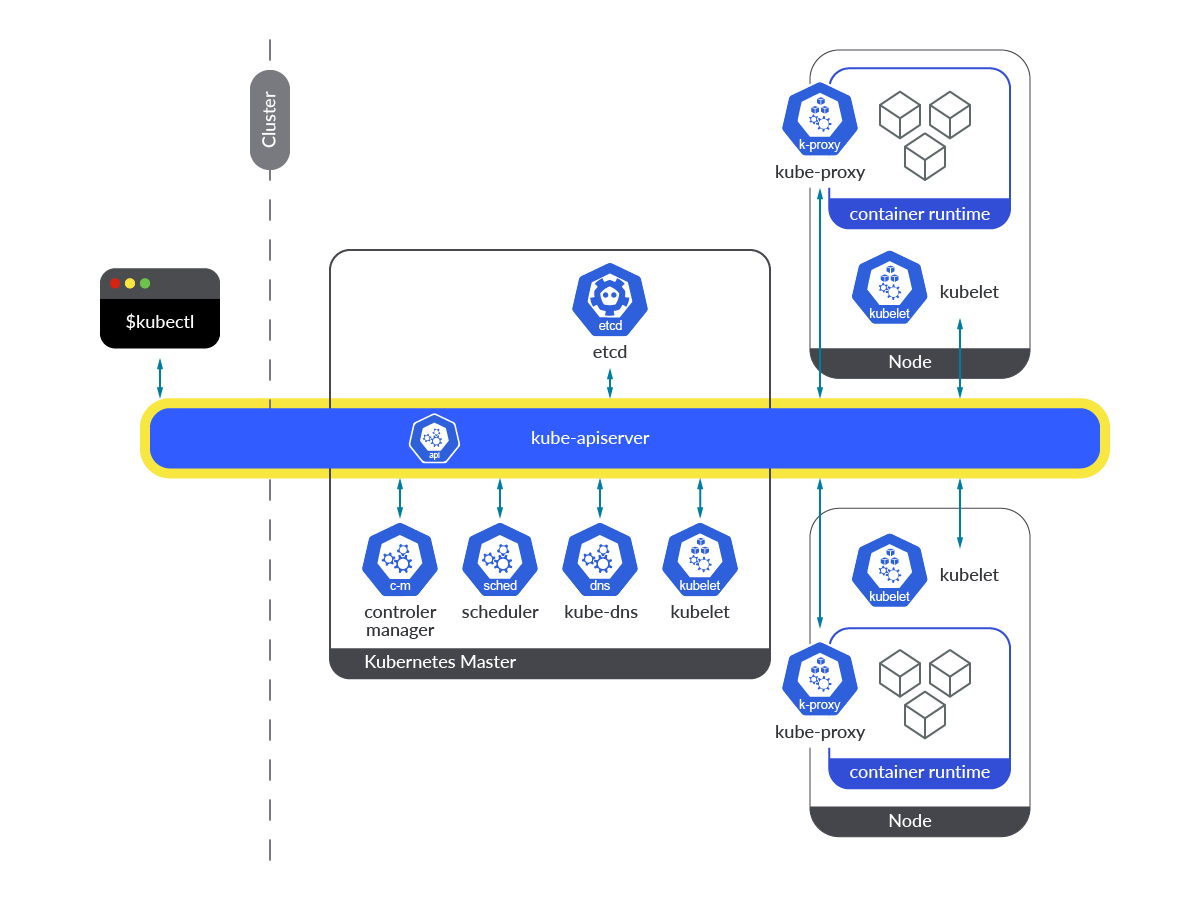 https://www.sysdig.com/jp/blog/monitor-kubernetes-api-server
kube-controller-manager
kube-controller-managerは、複数のコントローラーを一つのプロセスで実行するDaemonSetです。 api-serverを介してクラスタの状態をwatchし、イベントが通知された際に「リソースのあるべき状態」(=etcdに保存されたspec等)に近づけるように調整ループを実行します。
コントローラーは以下のものがあります。
- DeploymentController
- ReplicaSetController
- DaemonSetController
- EndpointSliceController
- JobController
例として、ReplicaSetControllerを見てみましょう。
例:ReplicaSetController
ReplicaSetは、指定した数分のPodを稼働させ続けることを保証するリソースでした。実際はこのコントローラーが動作することで、機能を満たしています。
// kubernetes/pkg/controller/replicaset/replica_set.go
// 超省略
func (rsc *ReplicaSetController) syncReplicaSet(ctx context.Context, key string) error {
    // 1. etcdから望ましい状態(ReplicaSet)を取得
    namespace, name, _ := cache.SplitMetaNamespaceKey(key)
    rs, err := rsc.rsLister.ReplicaSets(namespace).Get(name)
    if err != nil {
        return err  // 削除済みなら終了
    }

    // 2. 現在の状態(実際のPod)を取得
    selector, _ := metav1.LabelSelectorAsSelector(rs.Spec.Selector)
    allActivePods := controller.FilterActivePods(logger, allRSPods)
    activePods, _ := rsc.claimPods(ctx, rs, selector, allActivePods)

    // 3. 調整処理(manageReplicas)
    manageReplicasErr = rsc.manageReplicas(ctx, activePods, rs)

    // 4. ステータス更新
    newStatus := calculateStatus(rs, activePods, ...)
    updateReplicaSetStatus(logger, rsc.kubeClient, rs, newStatus)

    return manageReplicasErr
}
Pod(コンテナ)を実行するのはkubeletなので、コントローラーはetcdに保存しているオブジェクトを修正する形になります(api-server経由)。
では、Replica数=3であった場合にPodを自動修復するシナリオを考えてみます。
初期状態として、以下のようにetcdに保存されているとします。
// /registry/replicasets/default/my-rs
{
  "metadata": {
    "name": "my-rs",
    "namespace": "default"
  },
  "spec": {
    "replicas": 3,
    "selector": {"matchLabels": {"app": "nginx"}}
  },
  "status": {
    "replicas": 3,
    "readyReplicas": 3,
    "availableReplicas": 3
  }
}

// /registry/pods/default/my-rs-pod-1
{
  "spec": {...},
  "status": {"phase": "Running", "conditions": [{"type": "Ready", "status": "True"}]}
}

// /registry/pods/default/my-rs-pod-2
{
  "spec": {...},
  "status": {"phase": "Running", "conditions": [{"type": "Ready", "status": "True"}]}
}

// /registry/pods/default/my-rs-pod-3
{
  "spec": {...},
  "status": {"phase": "Running", "conditions": [{"type": "Ready", "status": "True"}]}
}
そこで3つ目のPodがクラッシュしたとしましょう。 kubeletはapi-server経由でPodのクラッシュを報告します。それによって以下のように変更されます。
// /registry/pods/default/my-rs-pod-3
{
  "spec": {...},
  "status": {
-   "phase": "Running",
+   "phase": "Failed",
    "conditions": [
-     {"type": "Ready", "status": "True"}
+     {"type": "Ready", "status": "False"}
    ],
+   "containerStatuses": [{
+     "state": {"terminated": {"exitCode": 137, "reason": "OOMKilled"}}
+   }]
  }
}
そこで、ReplicaSetControllerがイベント通知受けこれを検知し、Podオブジェクトを新たに作成します。まだ起動されたわけではないのでPending状態です。
+ // /registry/pods/default/my-rs-pod-4 (新規作成)
+ {
+   "metadata": {
+     "name": "my-rs-pod-4",
+     "namespace": "default",
+     "ownerReferences": [{
+       "kind": "ReplicaSet",
+       "name": "my-rs",
+       "uid": "abc123",
+       "controller": true
+     }]
+   },
+   "spec": {
+     "containers": [{
+       "name": "nginx",
+       "image": "nginx:1.21"
+     }],
+     "nodeName": ""  // まだ未割り当て
+   },
+   "status": {
+     "phase": "Pending" // まだ起動していない
+   }
+ }
加えて、replicasetオブジェクトの情報を書き換えます。
// /registry/replicasets/default/my-rs
{
  "spec": {
    "replicas": 3  // 変更なし
  },
  "status": {
-   "replicas": 3,
+   "replicas": 3,  // Pod-1,2,4 (Pod-3はphase=Failedで除外)
-   "readyReplicas": 3,
+   "readyReplicas": 2,  // Pod-1,2のみReady
-   "availableReplicas": 3
+   "availableReplicas": 2
  }
}
この後、kube-schedulerがこのPodをWorker Nodeに割り当て、kubeletがPendingからRunngingに変えた時点で、またコントローラーにイベントが通知されます。そして調整ループが実行され、readyReplicas,availableReplicasをもとに戻します。
// /registry/replicasets/default/my-rs
{
  "status": {
    "replicas": 3,
-   "readyReplicas": 2,
+   "readyReplicas": 3,  // Pod-1,2,4すべてReady
-   "availableReplicas": 2
+   "availableReplicas": 3
  }
}
また、コントローラーがetcdを直接操作しているのではなく、api-server経由であることは留意しておいてください。
kube-scheduler
kube-schedulerは、Worker NodeへのPodの割り当てを行います。
Filterロジックで実行可能なWorker Nodeを絞り込みます。CPU/メモリ要求を満たすか、ラベルセレクタが一致するかなどを見てフィルタリングします。
ScoreロジックでフィルタされたWorker Nodeらを採点し、最高得点のWorker Nodeを選択します。
最終的に、選択したWorker Nodeを割り当ててスケジュール完了とします(api-server経由)。
 {
 "metadata": {
     "name": "my-rs-pod-4",
     "namespace": "default",
     "ownerReferences": [{
     "kind": "ReplicaSet",
     "name": "my-rs",
     "uid": "abc123",
     "controller": true
     }]
 },
 "spec": {
     "containers": [{
     "name": "nginx",
     "image": "nginx:1.21"
     }],
-    "nodeName": ""  // まだ未割り当て
+    "nodeName": "node-2"
 },
 "status": {
-    "phase": "Pending" // まだ起動していない
+    "phase": "Pending",
+    "conditions": [
+      {
+        "type": "PodScheduled",
+        "status": "True",
+        "lastTransitionTime": "2025-12-31T10:00:00Z"
+      }
+    ]
 }
 }
これをkubeletが見て、Podが該当のWorker Nodeで起動するようになります。
etcd
etcdは、クラスター内のリソース全ての状態を保存する分散型のキーバリューストアになります。
etcdはそれでいてgRPCサーバーのようです。つまり、kube-api-server↔︎etcdの間はgRPC通信になります。
etcdはwatch APIを提供しており、api-serverは起動時にetcdをwatchします。そして、api-serverはstreamingで変更イベントを受け取ります。
etcdをwatchするクライアントメソッドを定義している箇所もありますね。
ここで、kubelet,api-server,etcdの関係図を簡単に整理してみました。kubectlコマンドでPodを追加するような変更を適用させたとします。
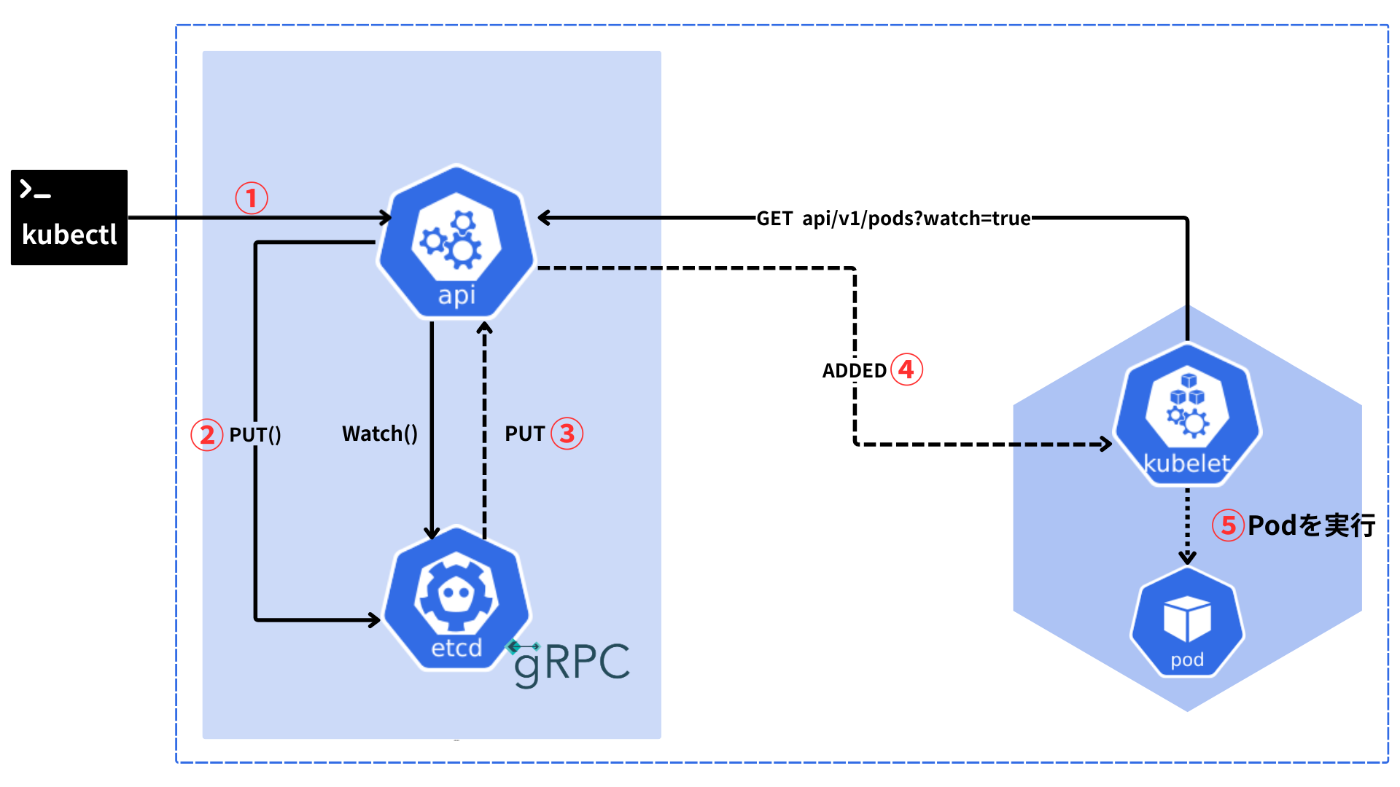
流れは以下のようになります。実際はもう少し複雑かとは思いますが、イメージです。
- 起動時に各コンポーネントがWatch接続
- kubelet → api-server (HTTP)
- api-server → etcd (gRPC)
- kubectlコマンドでPod追加を実行し、api-serverが受信
kubectl apply -f pod.yaml- 内部的には
POST /api/v1/namespaces/default/podsといったPOSTリクエスト - docs
- api-serverがetcdの
PUT()を叩いて新規Podオブジェクトを保存PUT()はetcd gRPCサーバーに用意されたメソッド- docs
- etcdはapi-serverに
PUTイベントを通知- PUTのイベントタイプは、ストアに新しい値が保存されたことを意味する
- docs
// 超省略レスポスンスメッセージのイメージ
WatchResponse {
  events: [{
    type: PUT           // ← etcdイベント
    kv: { version: 1 }
  }]
}
- api-serverは3を受けてkubeletに
ADDEDイベントを通知 - kubeletがPodを実行
さて、かなりk8sに関する説明も長くなってしまいましたが、k8sのリソース&コンポーネントを知ることで、ある程度仕組みの理解もクリアになってきたのではないでしょうか。
(やっと)次からリソースを定義していきましょう。
manifestを用意(管理)する
マニフェスト(manifest)とは、k8sオブジェクトを宣言的に定義するYAML/JSONァイルであり、クラスターに対して「リソースの望ましい状態(desired state)」を記述します。
作成したマニフェストは kubectl apply コマンドでクラスターに適用します。
kubectl apply -f manifest.yaml
また、kubectl applyは冪等性を持ち、同じマニフェストを何度適用してもクラスターの状態は常に定義された内容に収束します。
構成
以下に、今回用意するマニフェストの構成をリソースごとにまとめます。
- Deployment
- マルチコンテナPod (Goアプリ + nginxサイドカー)
- RollingUpdate戦略 (maxSurge/maxUnavailable設定可能)
- 両コンテナにCPU/メモリのrequests/limits設定
- ConfigMapでnginx設定を注入 (リバースプロキシ設定)
- nginxがポート80で受けて、localhostのGoアプリにproxy_pass
- Service
- NodePortタイプ
- targetPort: 80 (nginxコンテナ)
- nginxがGoアプリケーションコンテナにリクエストを流す。
- HorizontalPodAutoscaler
- CPU/メモリの両方でPodのReplica数をスケーリング
HorizontalPodAutoscaler
HorizontalPodAutoscaler(HPA)は、PodのCPU・メモリなどのメトリクスをもとに、Replica数を自動的に増減させるk8sのコントローラです。
HPAは定期的にメトリクスを取得し、定義された目標値(target)と現在値を比較してスケーリングを行います。
HPA が利用するメトリクスは、k8sのMetrics API(metrics.k8s.ioなど)を通じて提供されます。
そのため、HPAを利用するにはmetrics-serverなどのMetrics APIコンポーネントがクラスター内で動作している必要があります。
今回は、hpaを有効に利用するためのメトリクスサーバーとして、metrics-serverを利用します。metrics-serverのpodも追加で起動するということになります。
Helm Chartを定義する
今回は、k8sを動かす環境が二つあります。
- 開発環境(4章のKindクラスター)
- 本番環境(6章のEKSクラスター)
双方の環境では、上述した「構成」は変わりないですがパラメータは変えたいところです。例えば、
- 開発環境ではPodがあまりスケールする必要はないが、本番環境では余裕を持ってスケールするようにしたい
- cpu/memoryのリソースを変えたい
- Goアプリケーションコンテナのイメージ名に含まれるリポジトリ名が環境によって異なる
- 開発環境ではローカルマシン上
- 本番環境ではECR
などなど。
環境ごとにマニフェストを複製して管理することもできますが、それでは DRY の原則に反し、メンテナンスもしづらくなります。
そこで、これらの課題を解決する手段としてHelm Chartを利用します。
Helm Chartとは何か
Helm Chartとはマニフェストをテンプレート化し、再利用可能な形で管理するための仕組みです。
1 つの Chart は、以下のようなファイル構成を持ちます。
my-chart/
├── Chart.yaml          # Chartのメタデータ(名前・バージョン・依存関係など)
├── values.yaml         # デフォルト値
├── templates/          # Kubernetesマニフェストのテンプレート
│   ├── deployment.yaml # Deploymentのテンプレート(Pod・image・resources 等)
│   ├── service.yaml    # Serviceのテンプレート(Podへの通信定義)
│   └── ...
└── .helmignore         # Chartに含めないファイル定義(.gitignore相当)
Helm は、このChart(テンプレート)とvalues.yaml(パラメータ)を組み合わせることで、最終的にk8sに適用される完全なマニフェスト(YAML)を生成します。
なお、記法はgo/templateになります。
Helm Chartを記述する
先述した「構成」を満たすHTTPサーバーのChartを作成していきます。
ルートディレクトリから/k8sを切って、以下のようにファイルを用意します。
k8s/charts/http-server
├── Chart.yaml
├── templates
│   ├── deployment.yaml
│   ├── hpa.yaml
│   └── service.yaml
└── values.yaml
このChartのメタデータ的情報を記述します。
k8s/charts/http-server/Chart.yaml
# k8s/charts/http-server/Chart.yaml
apiVersion: v2
name: http-server
description: A Helm chart for HTTP server with nginx reverse proxy
type: application
version: 0.1.0
appVersion: "0.1.0"
keywords:
  - http-server
  - nginx
maintainers:
  - name: kakkky
リソースごとにファイルを分ける必要はありませんが、整理のため、リソースは分けて記述します。
以下はDeploymentリソースのテンプレートです。{{...}}となっているところ以外は単なるk8sマニフェストの構造になっています。
k8s/charts/http-server/templates/deployment.yaml
# k8s/charts/http-server/templates/deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: {{ .Release.Name }}-{{ .Chart.Name }}
  labels:
    app: {{ .Release.Name }}-{{ .Chart.Name }}
spec:
  replicas: {{ .Values.deployment.replicaCount }}
  strategy:
    type: {{ .Values.deployment.strategy.type }}
    {{- if eq .Values.deployment.strategy.type "RollingUpdate" }}
    rollingUpdate:
      maxSurge: {{ .Values.deployment.strategy.rollingUpdate.maxSurge }}
      maxUnavailable: {{ .Values.deployment.strategy.rollingUpdate.maxUnavailable }}
    {{- end }}
  selector:
    matchLabels:
      app: {{ .Release.Name }}-{{ .Chart.Name }}
  template:
    metadata:
      labels:
        app: {{ .Release.Name }}-{{ .Chart.Name }}
    spec:
      containers:
        - name: {{ .Chart.Name }}
          image: "{{ .Values.deployment.image.repository }}:{{ .Values.deployment.image.tag }}"
          ports:
            - containerPort: {{ .Values.deployment.containerPort }}
          resources:
            requests:
              cpu: {{ .Values.deployment.resources.requests.cpu }}
              memory: {{ .Values.deployment.resources.requests.memory }}
            limits:
              cpu: {{ .Values.deployment.resources.limits.cpu }}
              memory: {{ .Values.deployment.resources.limits.memory }}
        - name: nginx
          image: nginx:1.25
          ports:
            - containerPort: 80
          volumeMounts:
            - name: nginx-conf
              mountPath: /etc/nginx/nginx.conf
              subPath: nginx.conf
          resources:
            requests:
              cpu: {{ .Values.deployment.nginx.resources.requests.cpu }}
              memory: {{ .Values.deployment.nginx.resources.requests.memory }}
            limits:
              cpu: {{ .Values.deployment.nginx.resources.limits.cpu }}
              memory: {{ .Values.deployment.nginx.resources.limits.memory }}
      volumes:
        - name: nginx-conf
          configMap:
            name: {{ .Release.Name }}-nginx-conf
            items:
              - key: nginx.conf
                path: nginx.conf

---
apiVersion: v1
kind: ConfigMap
metadata:
  name: {{ .Release.Name }}-nginx-conf
data:
  nginx.conf: |
    events {}
    http {
      server {
        listen 80;
        location / {
          proxy_pass http://localhost:{{ .Values.deployment.containerPort }};
          proxy_set_header Host $host;
          proxy_set_header X-Real-IP $remote_addr;
        }
      }
    }
deployment.yamlに含まれるConfigMapは、設定ファイルや環境変数などの非機密データを保存するリソースになります。Podから分離して設定を管理 (コンテナイメージに設定を埋め込まない)できます。
nginx.confというキーで定義しています。
apiVersion: v1
kind: ConfigMap
metadata:
  name: {{ .Release.Name }}-nginx-conf
data:
  nginx.conf: |
    ...
volume定義では、上のConfigMap({{ .Release.Name }}-nginx-conf)のnginx.confキーの値をnginx.confというファイル名で置いています。
volumes:
- name: nginx-conf
  configMap:
    name: {{ .Release.Name }}-nginx-conf # ConfigMap参照
    items:
      - key: nginx.conf # ConfigMapのkey
        path: nginx.conf # マウント時のファイル名
nginxコンテナの中で以下のようにvolumeをマウントする形で利用しています。
containers:
  - name: nginx
    volumeMounts:
      - name: nginx-conf           # Volume名
        mountPath: /etc/nginx/nginx.conf  # コンテナ内のパス
        subPath: nginx.conf        # ファイル単位でマウント
続いてServiceリソースは、typeを指定できるようにしておきます。
typeにClusterIPを指定することも可能です。Nodeportにする場合は、nodePortフィールドも記述する必要があります。
k8s/charts/http-server/templates/service.yaml
# k8s/charts/http-server/templates/service.yaml
apiVersion: v1
kind: Service
metadata:
  name: {{ .Release.Name }}-{{ .Chart.Name }}-service
  labels:
    app: {{ .Release.Name }}-{{ .Chart.Name }}
spec:
  type: {{ .Values.service.type }}
  selector:
    app: {{ .Release.Name }}-{{ .Chart.Name }}
  ports:
    - name: http
      port: 80
      targetPort: 80 # transfer to nginx container port
      {{- if eq .Values.service.type "NodePort" }}
      nodePort: {{ .Values.service.nodePort }}
      {{- end }}
HPAは、スケールするcpu/memoryの閾値や、replica数をパラメータで指定できるようにしておきます。
k8s/charts/http-server/templates/hpa.yaml
# k8s/charts/http-server/templates/hpa.yaml
{{- if .Values.hpa.enabled }}
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: {{ .Release.Name }}-{{ .Chart.Name }}
  labels:
    app: {{ .Release.Name }}-{{ .Chart.Name }}
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: {{ .Release.Name }}-{{ .Chart.Name }}
  minReplicas: {{ .Values.hpa.minReplicas }}
  maxReplicas: {{ .Values.hpa.maxReplicas }}
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: {{ .Values.hpa.targetCpuUtilizationPercentage }}
    - type: Resource
      resource:
        name: memory
        target:
          type: Utilization
          averageUtilization: {{ .Values.hpa.targetMemoryUtilizationPercentage }}
{{- end }}
以下がこのChartを利用するときのデフォルト値になります。
k8s/charts/http-server/values.yaml
# k8s/charts/http-server/values.yaml
# Deployment settings
deployment:
  name: myapp
  replicaCount: 2
  # Application container image
  image:
    repository: myapp
    tag: "latest"

  # Application container port
  containerPort: 8080

  # Application container resources
  resources:
    requests:
      cpu: "100m"
      memory: "128Mi"
    limits:
      cpu: "500m"
      memory: "512Mi"

  # Nginx sidecar resources
  nginx:
    resources:
      requests:
        cpu: "10m"
        memory: "32Mi"
      limits:
        cpu: "100m"
        memory: "128Mi"

# Horizontal Pod Autoscaler settings
hpa:
  enabled: true
  minReplicas: 3
  maxReplicas: 5
  targetCpuUtilizationPercentage: 60
  targetMemoryUtilizationPercentage: 70

# Service settings
service:
  type: NodePort
  nodePort: 30080
Helmfileを記述する
ここまでで、Helm Chart を使うことで 「構成は共通だが、環境ごとにパラメータを変えたい」という課題が解決されることがわかりました。
一方で、Helmだけで複数環境を運用しようとすると、以下のような不便さがあります。
- 環境ごとの状態を宣言的に定義できない
- 環境ごとのデプロイがコマンドベースなので再現性が低い
helmコマンドでデプロイした場合の例
開発環境
helm upgrade --install http-server-dev ./k8s/charts/http-server \
  --namespace dev \
  --create-namespace \
  -f values.yaml \
  -f values-dev.yaml
本番環境
helm upgrade --install http-server-prod ./k8s/charts/http-server \
  --namespace prod \
  --create-namespace \
  -f values.yaml \
  -f values-prod.yaml
そこで、Helmfileというツールを使い、この点を解決します。
Helmfileとは何か
Helmfileの特徴は以下のようなものがあります。
- 複数の Helm Chart をまとめて宣言的に管理できる
- どのChartを、どのversionで、どのvaluesで、どのnamespaceにデプロイするかを1つのYAMLファイルに記述できる。
- 環境ごとの差分(dev / prod など)をコードとして明確に表現できる
- values ファイルの切り替えや環境別設定をコマンドではなく設定ファイルで管理できる。
helmfile applyだけで環境全体を再現でき、再現性と運用性が高い- 手順書に頼らず、CI/CDやGitOpsと相性の良い運用が可能。
helmfile.yamlを記述する
以下のようにhelmfileを用意します。なお、go/templateを用いた条件分岐を記述したかったため、ここでは拡張子にgotmplを指定します。
k8s/helmfile.yaml.gotmpl
# k8s/helmfile.yaml.gotmpl
environments:
  development:
    kubeContext: kind-sandbox

  production:
    kubeContext: eks-sandbox


repositories:
  - name: metrics-server
    url: https://kubernetes-sigs.github.io/metrics-server/

---
releases:
  - name: app
    namespace: "app-{{ .Environment.Name }}"
    chart: ./charts/http-server
    values:
      - values/{{ .Environment.Name }}/values.yaml
    installed: true
    atomic: false # Rollback on failure is disabled for learning purposes

  - name: metrics-server
    namespace: kube-system
    chart: metrics-server/metrics-server
    version: 3.12.1
    {{- if eq .Environment.Name "development" }}
    values:
      - args:
          - --kubelet-insecure-tls
    {{- end }}
enviroments
enviromentsフィールドを使って、環境ごとに設定値を切り替えることができます。
以下では、kubeContextを切り替えるようにしています。
environments:
  development:
    kubeContext: kind-sandbox

  production:
    kubeContext: eks-sandbox
kubeContextは、k8sのcontextという概念に対応します。
contextとは、以下のような情報をひとまとめにした設定の単位です。
- 接続先のクラスタ
- 認証情報(ユーザー)
- デフォルトの namespace
kubectl config use-contextで切り替えてkubectl applyすることが多いです。
releases
Helmのリリース単位(helm install/upgradeに相当)を定義します。
利用するChartと、適用するvalues.yamlを指定できます。以下のように、環境ごとに利用するvalues.yamlのパスを変えるようにすることで、切り替えられるようにしています。
releases:
  - name: app
    namespace: "app-{{ .Environment.Name }}"
    chart: ./charts/http-server
    values:
      - values/{{ .Environment.Name }}/values.yaml
    installed: true
    atomic: false # Rollback on failure is disabled for learning purposes
envorimentsとreleasesの設定を踏まえて整理すると、
helmfile apply -e development
とコマンドを実行した場合、
kind-sandboxのコンテキスト(= Kindクラスターに対して)で、./charts/http-serverのChartを用いて、values/development/values.yamlをvaluesとして展開して、
デプロイできるということになります。
次章にて扱いますが、kind-sandboxというコンテキスト名になるようにKindクラスターを作成していきます。
metrics-server
先述したように、hpaを利用するにはPodのCPU/メモリ使用量などのリソースメトリクスを取得するための Metrics APIが必要です。
ここでは、http-server のリリースとは別にmetrics-serverのreleaseをHelmfileに定義しておきます。
repositories:
  - name: metrics-server
    url: https://kubernetes-sigs.github.io/metrics-server/
---
releases:
  - name: app
    ...

  - name: metrics-server
    namespace: kube-system
    chart: metrics-server/metrics-server
    version: 3.12.1
    {{- if eq .Environment.Name "development" }}
    values:
      - args:
          - --kubelet-insecure-tls
    {{- end }}
repositoriesフィールドを使って、Helm Chartを取得するリポジトリの名前とURLを宣言的に定義できます。内部的にはhelm repo addが実行されます。
取得したいChartはmetrics-server/metrics-serverになります。
環境別のvalues.yamlを用意する
以下のようにアプリケーションのreleaseを定義していました。
releases:
  - name: app
    namespace: "app-{{ .Environment.Name }}"
    chart: ./charts/http-server
    values:
      - values/{{ .Environment.Name }}/values.yaml
    installed: true
    atomic: false # Rollback on failure is disabled for learning purposes
これによって、環境ごとに参照されるvalues.yamlが切り替わるのでした。
helmfile apply -e developmentと実行した場合:values/development/values.yamlが適用
helmfile apply -e productionと実行した場合:values/production/values.yamlが適用
以下のようにファイルを作成し、記述しておきましょう。 Nodeportは
k8s/values/development/values.yaml
# k8s/values/development/values.yaml
deployment:
  name: app
  replicaCount: 3
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 100%
      maxUnavailable: 25%
  image:
    repository: app
    tag: "local"
  containerPort: 8080
  resources:
    requests:
      cpu: "100m"
      memory: "128Mi"
    limits:
      cpu: "500m"
      memory: "512Mi"
  nginx:
    resources:
      requests:
        cpu: "10m"
        memory: "32Mi"
      limits:
        cpu: "100m"
        memory: "128Mi"

hpa:
  enabled: true
  minReplicas: 3
  maxReplicas: 5
  targetCpuUtilizationPercentage: 60
  targetMemoryUtilizationPercentage: 70

service:
  type: NodePort
  nodePort: 30080
k8s/values/production/values.yaml
# k8s/values/production/values.yaml
deployment:
  name: app
  replicaCount: 1
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 100%
      maxUnavailable: 25%
  image:
    repository: 846869429016.dkr.ecr.ap-northeast-1.amazonaws.com/eks-sandbox-ecr-repository
    tag: "20251206224539"
  containerPort: 8080
  resources:
    requests:
      cpu: "100m"
      memory: "128Mi"
    limits:
      cpu: "500m"
      memory: "512Mi"
  nginx:
    resources:
      requests:
        cpu: "10m"
        memory: "32Mi"
      limits:
        cpu: "100m"
        memory: "128Mi"
hpa:
  enabled: true
  minReplicas: 1
  maxReplicas: 3
  targetCpuUtilizationPercentage: 60
  targetMemoryUtilizationPercentage: 70
service:
  type: NodePort
  nodePort: 30080
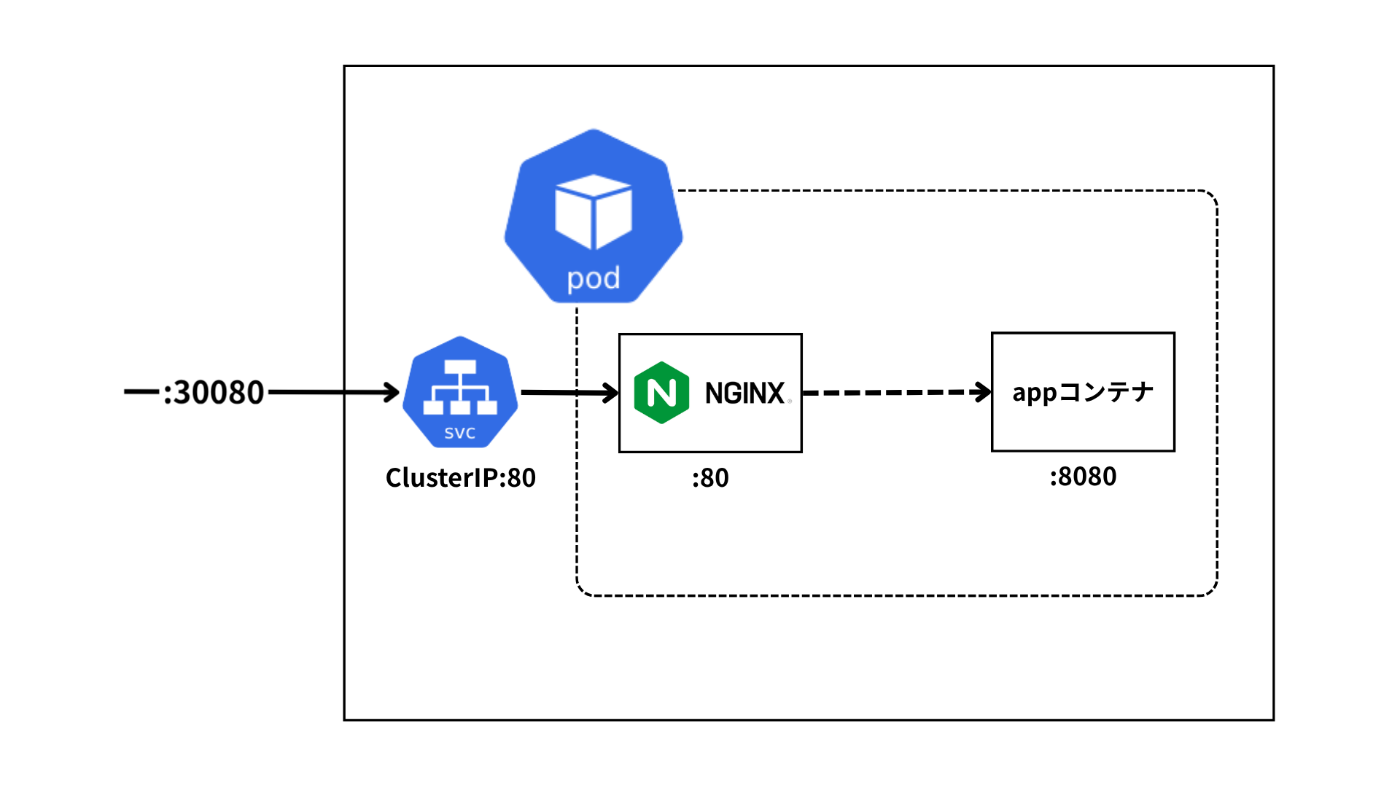
パッとみ、ポート番号とかがややこしそうなので以下にイメージ図を載せておきます。以下は本番でも開発環境でも同じです。
Worker Nodeの:30080番ポートへの通信を、Pod IPの:80ポート(nginxコンテナ)へ転送します。そして、そのnginxコンテナがlocalhost:8080へプロキシします。
productionの方のコンテナイメージの指定は後々書き換えますが、一旦そのままにしておいてください。
  image:
    repository: 846869429016.dkr.ecr.ap-northeast-1.amazonaws.com/eks-sandbox-ecr-repository
    tag: "20251206224539"
development環境とproduction環境ではほぼパラメータを同じにしています。
というのも、ここでは「環境ごとに切り替えられる」ということを扱いたいだけなので、リソース調整等は適当に行なっています。
相当長くなってしまいましたがこの章は終わりです。次章ではKindクラスターにデプロイしていきます。